
Khi nhãn nói "không" nhưng embedding nói "có": Lỗ hổng của cách đánh giá tìm kiếm truyền thống
Các chỉ số đánh giá tìm kiếm dựa trên nhãn danh mục có thể bỏ sót những mối liên hệ ngữ nghĩa thực sự mà mô hình embedding như CLIP nắm bắt được. Nghiên cứu trên 9.315 ảnh kiến trúc cho thấy phần lớn các trường hợp bị coi là "sai" thực chất lại có độ tương đồng kiến trúc cao hơn hẳn mức ngẫu nhiên.
Khi nhãn nói "không" nhưng embedding nói "có"
Hãy tưởng tượng bạn vừa trúng số và quyết định mua một chiếc Ferrari. Bạn vào trang web xe sang, tìm thấy một mẫu xe thể thao tuyệt đẹp và bấm "Tìm xe tương tự". Kết quả trả về bốn chiếc Ferrari (tuyệt!), một chiếc Lamborghini (cũng hay!) và một chiếc SUV Ferrari (khoan đã, cái gì thế này?).
Đây không chỉ là một tình huống dở khóc dở cười, mà còn là điểm khởi đầu cho một câu hỏi hóc búa về cách chúng ta đánh giá các hệ thống tìm kiếm và truy xuất dựa trên AI ngày nay.
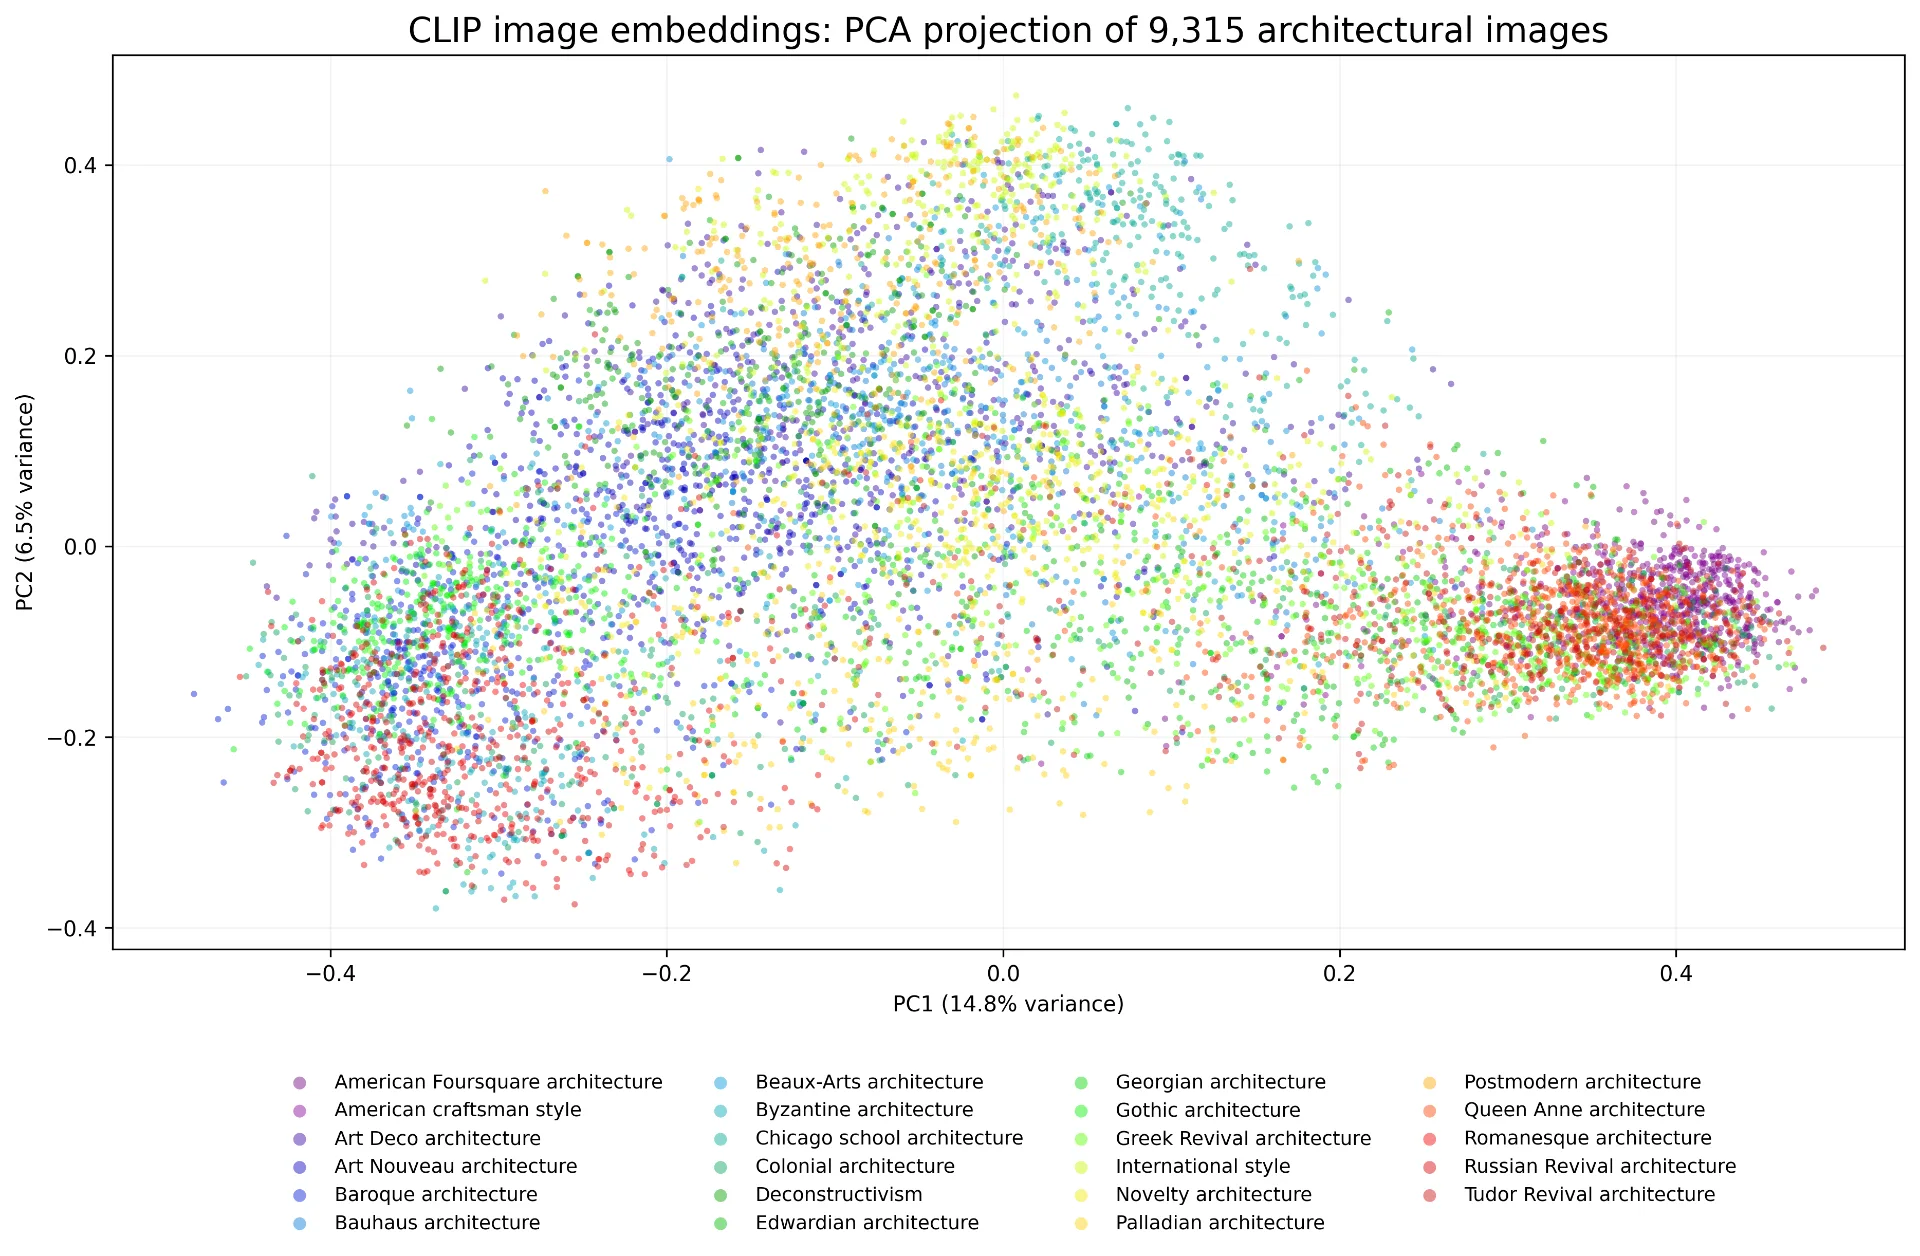 Minh họa hệ thống tìm kiếm hình ảnh bằng AI
Vấn đề: Nhãn danh mục không đồng nghĩa với sự tương đồng
Chiếc Lamborghini xuất hiện trong kết quả bởi nó chia sẻ những đặc điểm thị giác đã thu hút bạn ở chiếc Ferrari: thiết kế thấp, đường cong mượt mà và phong cách thể thao. Còn chiếc SUV Ferrari? Có lẽ hệ thống đã dành trọng số lớn cho các đặc điểm gắn với thương hiệu Ferrari, bất chấp hình dáng hoàn toàn khác biệt.
Giờ đến phần thú vị. Giả sử công cụ tìm kiếm được đánh giá bằng một bộ benchmark chỉ coi hai chiếc xe là "liên quan" nếu chúng cùng nhãn thương hiệu. Khi đó, chiếc Lamborghini mà bạn thực sự thích sẽ bị tính là sai, còn chiếc SUV Ferrari mà bạn chẳng muốn lại được điểm tuyệt đối.
Điều này phơi bày một hạn chế lớn của phương pháp đánh giá truy xuất dựa trên danh mục: tương đồng ngữ nghĩa và sự trùng khớp nhãn không nhất thiết là một.
Một hệ thống truy xuất có thể khám phá những mối quan hệ có ý nghĩa giữa các đối tượng thuộc những danh mục khác nhau, nhưng lại bị trừ điểm chỉ vì nhãn của chúng không khớp. Vậy câu hỏi đặt ra là: khi embedding tìm ra sự tương đồng có ý nghĩa mà nhãn không nhận ra, liệu có nên gọi đó là lỗi?
Thí nghiệm với CLIP và dữ liệu kiến trúc
Để trả lời câu hỏi này, nhóm nghiên cứu sử dụng CLIP — một trong những mô hình thị giác - ngôn ngữ nổi tiếng nhất, có khả năng biểu diễn hình ảnh và văn bản trong cùng một không gian embedding chung. Họ chọn kiến trúc làm lĩnh vực thử nghiệm, bởi các công trình thuộc những phong cách khác nhau hoàn toàn có thể có chung mái nhà, cửa sổ, vật liệu, tính đối xứng và chi tiết trang trí.
Bộ dữ liệu từ Kaggle gồm 9.315 hình ảnh thuộc 23 phong cách kiến trúc (sau khi loại bỏ hai danh mục chủ yếu là di tích cổ). Mỗi hình ảnh đóng vai trò một truy vấn, và CLIP trả về các hình ảnh tương đồng nhất dựa trên độ tương đồng cosine giữa các embedding.
Kết quả cơ sở
Khi đánh giá theo cách truyền thống — một hình ảnh được coi là "đúng" nếu cùng nhãn phong cách với truy vấn — nhóm nghiên cứu thu được:
- Precision@1: 0,7354
- Precision@5: 0,6461
- Precision@10: 0,6065
Thoạt nhìn, CLIP làm khá tốt: khoảng 73,5% kết quả xếp hạng đầu tiên có cùng nhãn phong cách. Nhưng điều đáng chú ý nằm ở 26,5% còn lại — tương đương 2.465 truy vấn bị đánh giá là sai, kể cả khi các phong cách đó có quan hệ mật thiết như Gothic và Romanesque, hay Bauhaus và International Style.
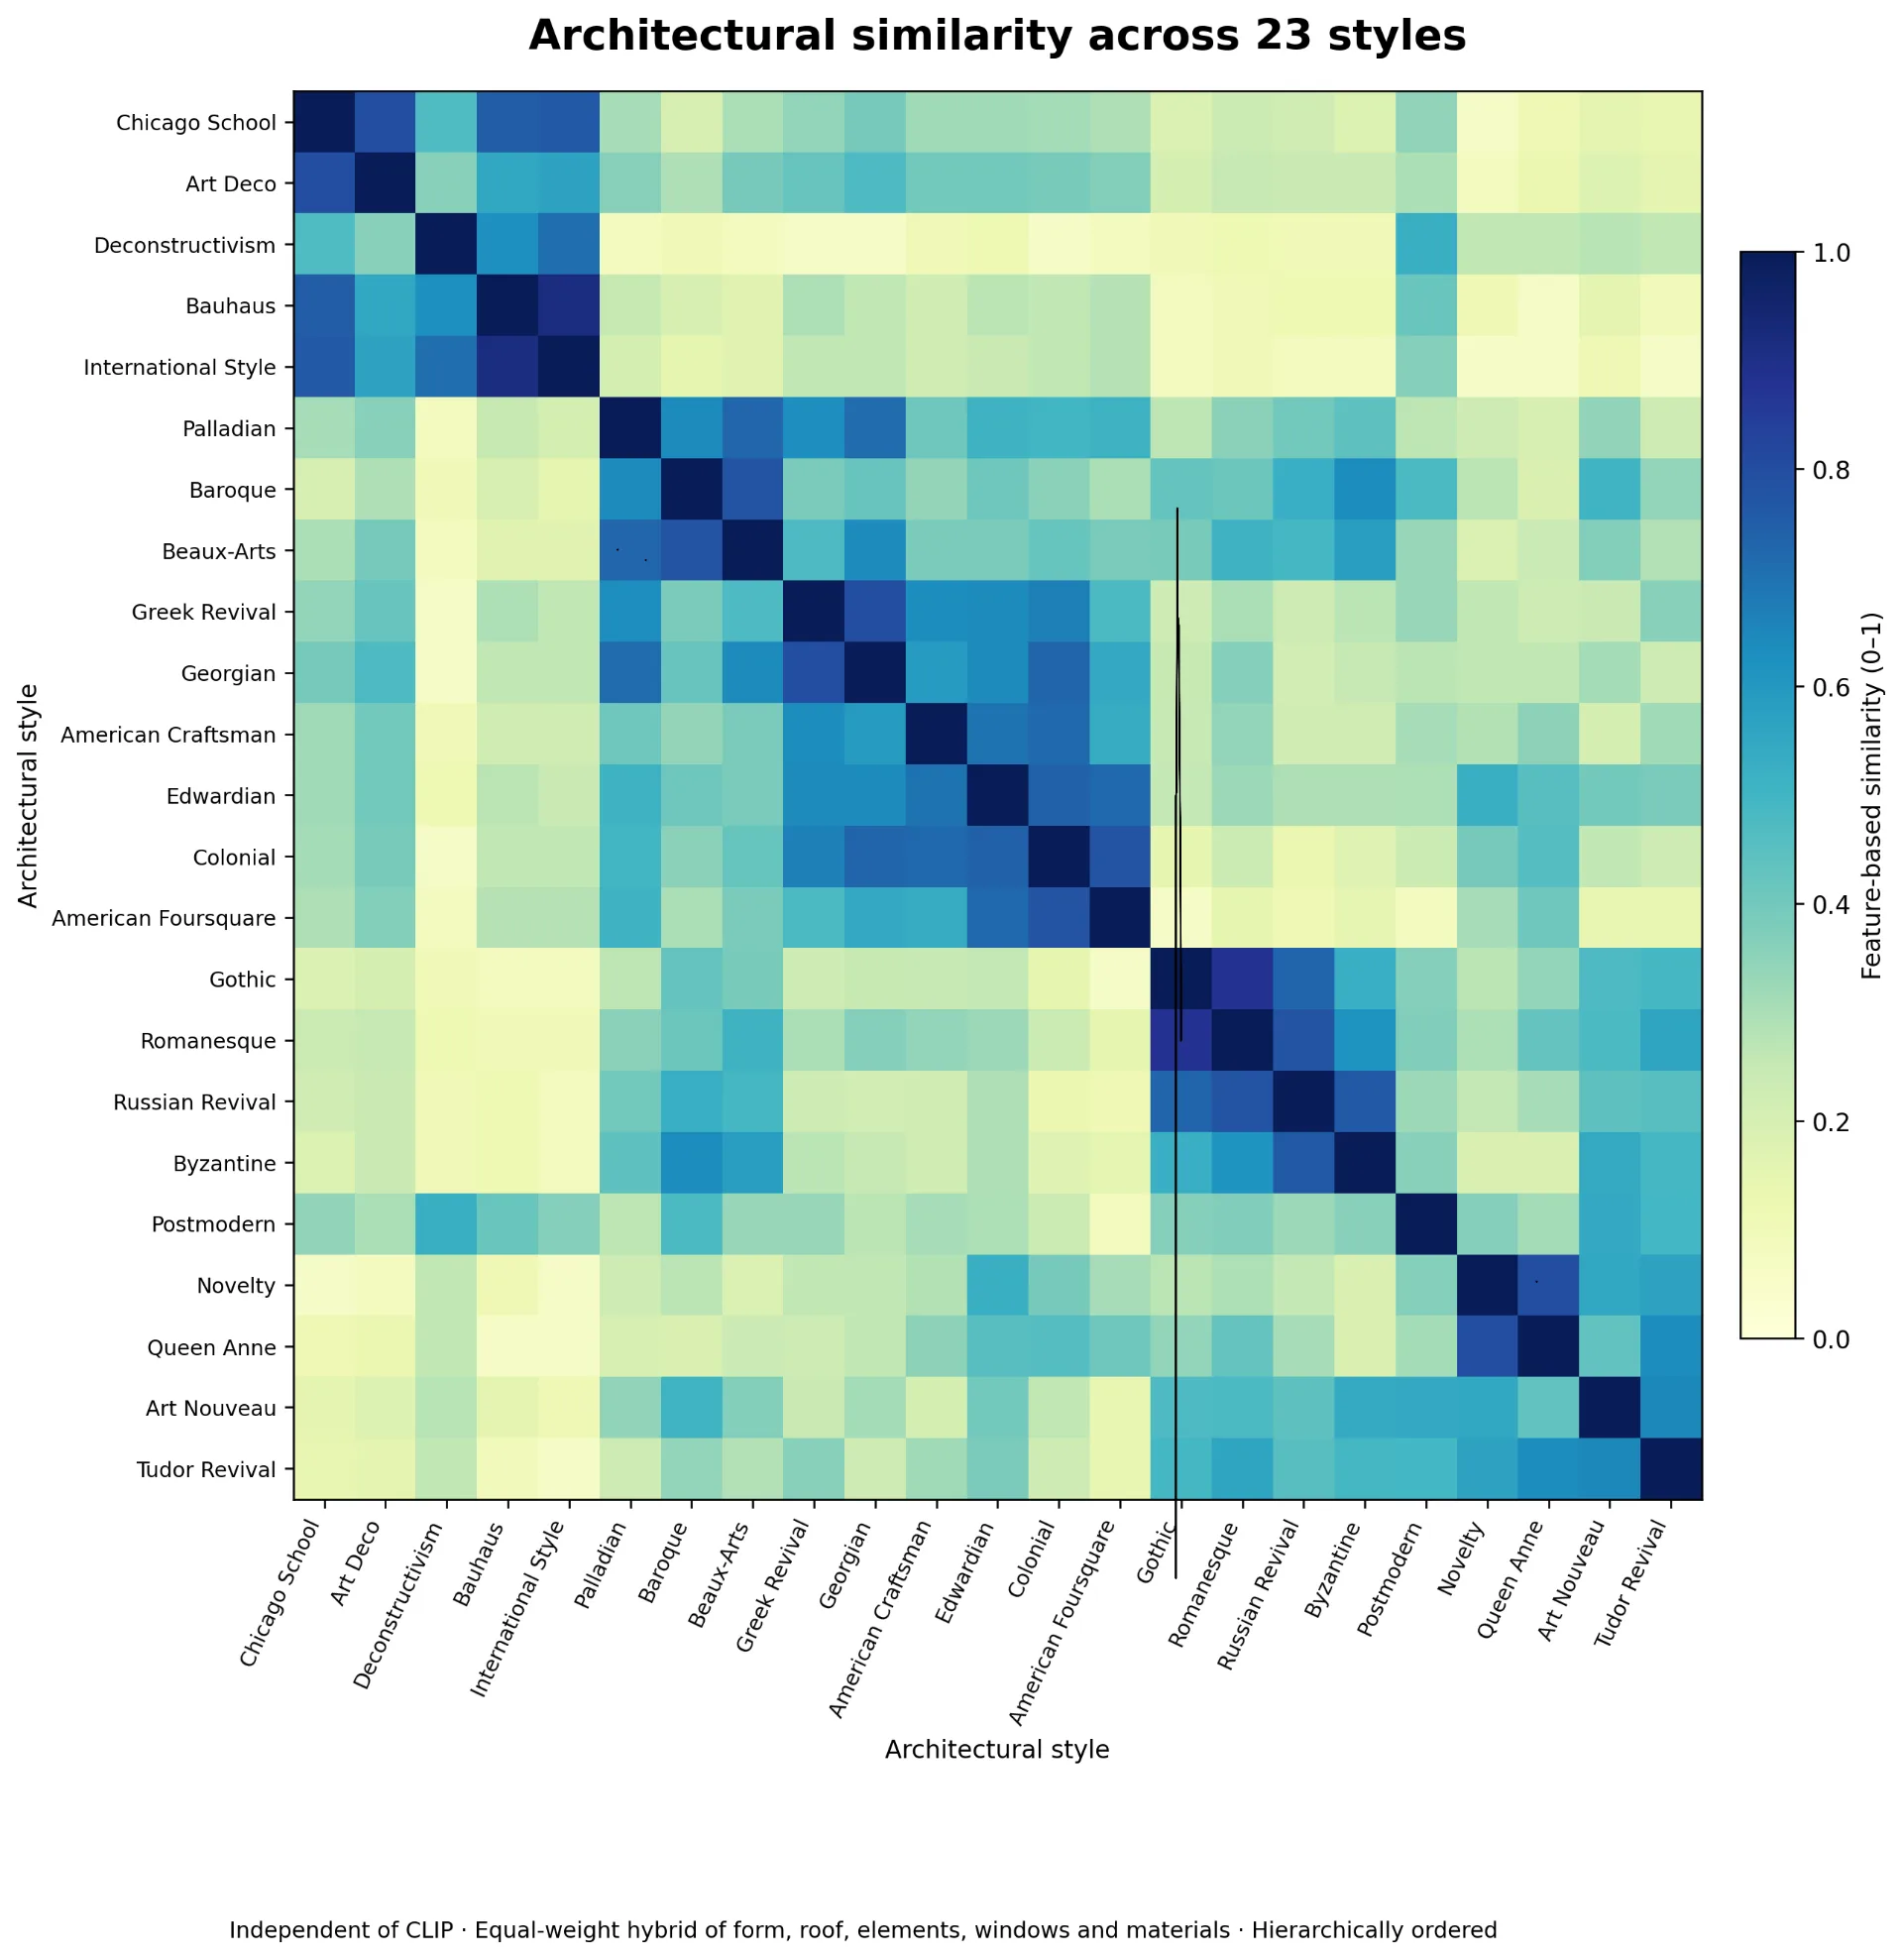 Trực quan hóa không gian embedding và độ tương đồng
Đo lường sự tương đồng kiến trúc thực sự
Để kiểm tra xem những "lỗi" này có thực sự là lỗi hay không, nhóm nghiên cứu xây dựng một thước đo độc lập với embedding của CLIP, gọi là M_feature. Thước đo này so sánh các phong cách kiến trúc dựa trên những đặc điểm chung, bao gồm 5 nhóm:
- Hình thức tổng thể: tính đối xứng, độ dọc, tính hình học đều đặn, độ phức tạp khối tích, mức độ trang trí (thang bậc 0-2).
- Kiểu mái: các cấu hình mái đặc trưng.
- Yếu tố kiến trúc: vòm, cột và các chi tiết kết cấu đặc thù.
- Cửa sổ: hình dạng và cách bố trí đặc trưng.
- Vật liệu: đá, gạch, gỗ, vôi vữa, kính/thép.
Họ kết hợp hai phép đo — độ tương đồng Jaccard (cho các thuộc tính dạng tập hợp) và độ tương đồng thứ bậc (cho các đặc điểm dạng cấp độ) — để tạo ra điểm số tương đồng kiến trúc trong khoảng 0 đến 1.
Kết quả cho thấy một số cặp có quan hệ mạnh mẽ, phù hợp với đặc trưng kiến trúc đã biết:
- Bauhaus - International Style: 0,917
- Gothic - Romanesque: 0,880
- Greek Revival - Georgian: 0,800
- Russian Revival - Byzantine: 0,760
Phát hiện then chốt: Lỗi của CLIP không hề ngẫu nhiên
Đây là phần quan trọng nhất. Nhóm nghiên cứu tính độ tương đồng kiến trúc của 2.465 trường hợp lệch nhãn ở Precision@1:
- Độ tương đồng trung bình: 0,5001
- Trung vị: 0,473
- Phân vị 90: 0,800, cao nhất: 0,917
Đáng chú ý, xét theo phân bố của toàn bộ 253 cặp phong cách, các lỗi này có thứ hạng phân vị trung bình là 71,2 — nghĩa là chúng thuộc nhóm những phong cách có độ tương đồng cao nhất.
Và để loại trừ khả năng đây chỉ là trùng hợp do tần suất xuất hiện khác nhau của các phong cách, họ tiến hành mô phỏng Monte Carlo 10.000 lần với baseline ngẫu nhiên có tính đến tần suất:
| Chỉ số | Giá trị |
|---|---|
| Độ tương đồng trung bình của CLIP | 0,5001 |
| Baseline ngẫu nhiên | 0,3500 |
| Khoảng tin cậy 95% của mô phỏng | 0,3429 – 0,3573 |
| Giá trị p | 0,00009999 |
Không một lần nào trong 10.000 lần thử ngẫu nhiên đạt được mức trung bình cao như CLIP. Nói cách khác, các trường hợp bị coi là "sai" của CLIP có độ tương đồng kiến trúc cao hơn khoảng 43% so với chọn ngẫu nhiên — và điều này không thể giải thích bằng may mắn.
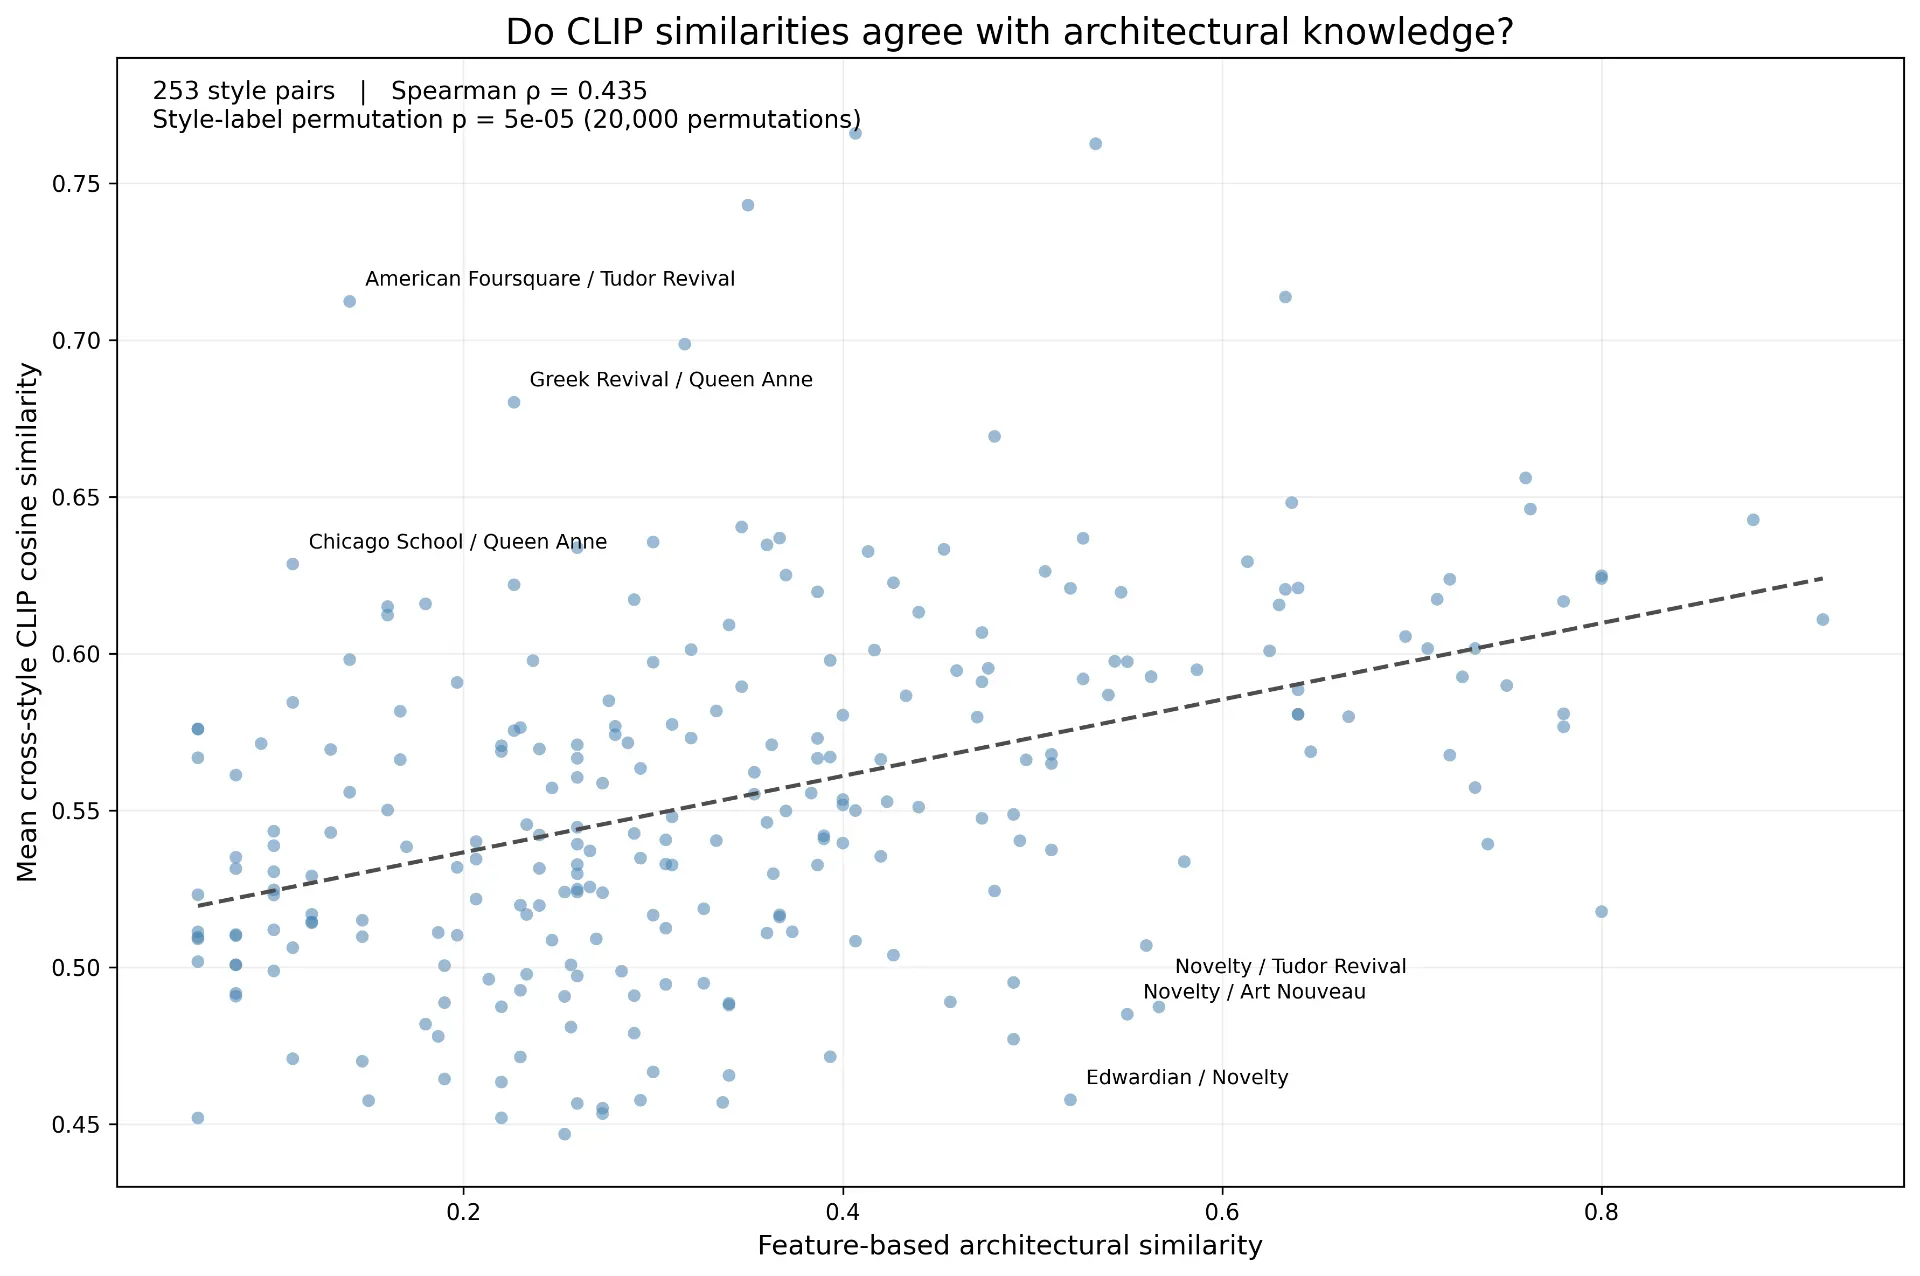 So sánh độ tương đồng kiến trúc và độ tương đồng cosine của CLIP
Ý nghĩa vượt ra ngoài lĩnh vực kiến trúc
Những hạn chế của phương pháp đánh giá dựa trên danh mục không chỉ giới hạn ở tìm kiếm hình ảnh kiến trúc. Trong tìm kiếm thời trang, quần áo khác danh mục có thể chia sẻ dáng, chất liệu hay yếu tố thiết kế tương tự. Trong tìm kiếm sản phẩm, các thương hiệu đối thủ có thể cung cấp sản phẩm gần như giống hệt. Trong tìm kiếm ngữ nghĩa, các tài liệu thuộc chủ đề khác nhau có thể diễn đạt những ý tưởng liên quan chặt chẽ.
Điều này cho thấy sự liên quan phụ thuộc vào ứng dụng cụ thể: ngoại hình có thể quan trọng nhất với thời trang, chức năng với tìm kiếm sản phẩm, và ý nghĩa với truy xuất tài liệu.
- Không phải mọi trường hợp lệch nhãn đều là lỗi thực sự.
- Một số lỗi xứng đáng được nhìn lại, đặc biệt khi chúng phản ánh mối quan hệ có ý nghĩa.
- Các chỉ số truyền thống như Precision@K nên được bổ sung bằng những thước đo tương đồng phù hợp với từng ứng dụng.
Mục tiêu của nghiên cứu không phải để chứng minh CLIP luôn đúng — một số sai lầm vẫn chỉ là sai lầm. Nhưng nhiều trường hợp khác xứng đáng được xem xét lại.
Suy cho cùng, nếu bạn yêu cầu một chiếc Ferrari thể thao mà lại nhận được một chiếc Lamborghini, liệu bạn có thực sự phàn nàn? Với các kỹ sư AI và những người đánh giá hệ thống tìm kiếm tại Việt Nam, bài học này càng trở nên thiết thực: khi xây dựng các sản phẩm tìm kiếm cho thị trường trong nước — từ sàn thương mại điện tử, ứng dụng bất động sản đến công cụ tìm kiếm nội bộ doanh nghiệp — việc chọn đúng tiêu chí đánh giá có thể quyết định liệu mô hình của bạn được "thưởng" hay bị "phạt" một cách oan uổng.
Bạn có thể tìm thấy bộ dữ liệu tại Kaggle và toàn bộ mã nguồn của nghiên cứu tại GitHub.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Chuyên gia độc hại: Khi kiến thức trở thành công cụ để hạ nhục người khác
29 tháng 10, 2026