Liên Hợp Quốc hợp tác với Google đưa dữ liệu toàn cầu lên nền tảng sẵn sàng cho AI
Liên Hợp Quốc ra mắt UN System Data Commons dựa trên nền tảng Data Commons mã nguồn mở của Google, cho phép truy vấn dữ liệu thống kê bằng ngôn ngữ tự nhiên và hỗ trợ giao thức MCP cho các tác nhân AI. Động thái này diễn ra sau khi một thử nghiệm của UNICEF phát hiện các mô hình AI hàng đầu chỉ đạt độ chính xác trung bình 21,2% khi truy xuất số liệu phát triển toàn cầu.
Liên Hợp Quốc vừa công bố hợp tác với Google nhằm biến kho dữ liệu thống kê khổng lồ của mình thành nguồn thông tin dễ tiếp cận và đáng tin cậy hơn đối với các hệ thống trí tuệ nhân tạo. Đây được xem là bước đi chiến lược trong bối cảnh ngày càng nhiều người dùng tìm đến AI để tra cứu thông tin, nhưng các mô hình hiện tại vẫn còn yếu kém trong việc truy xuất dữ liệu chính thống.
UN System Data Commons — nền tảng dữ liệu mới
Nền tảng mới mang tên UN System Data Commons được xây dựng trên Data Commons, hệ thống mã nguồn mở của Google. Nó cho phép người dùng tìm kiếm số liệu thống kê từ khắp các cơ quan Liên Hợp Quốc bằng truy vấn ngôn ngữ tự nhiên, thay vì phải duyệt qua giao diện cơ sở dữ liệu truyền thống như cổng UNData trước đây.
Điểm đáng chú ý là nền tảng này hỗ trợ Model Context Protocol (MCP) — một tiêu chuẩn cho phép các hệ thống AI kết nối trực tiếp với nguồn dữ liệu bên ngoài. Nhờ đó, các tác nhân AI có thể tự động truy vấn số liệu và nguồn gốc của chúng mà không cần con người can thiệp thủ công.
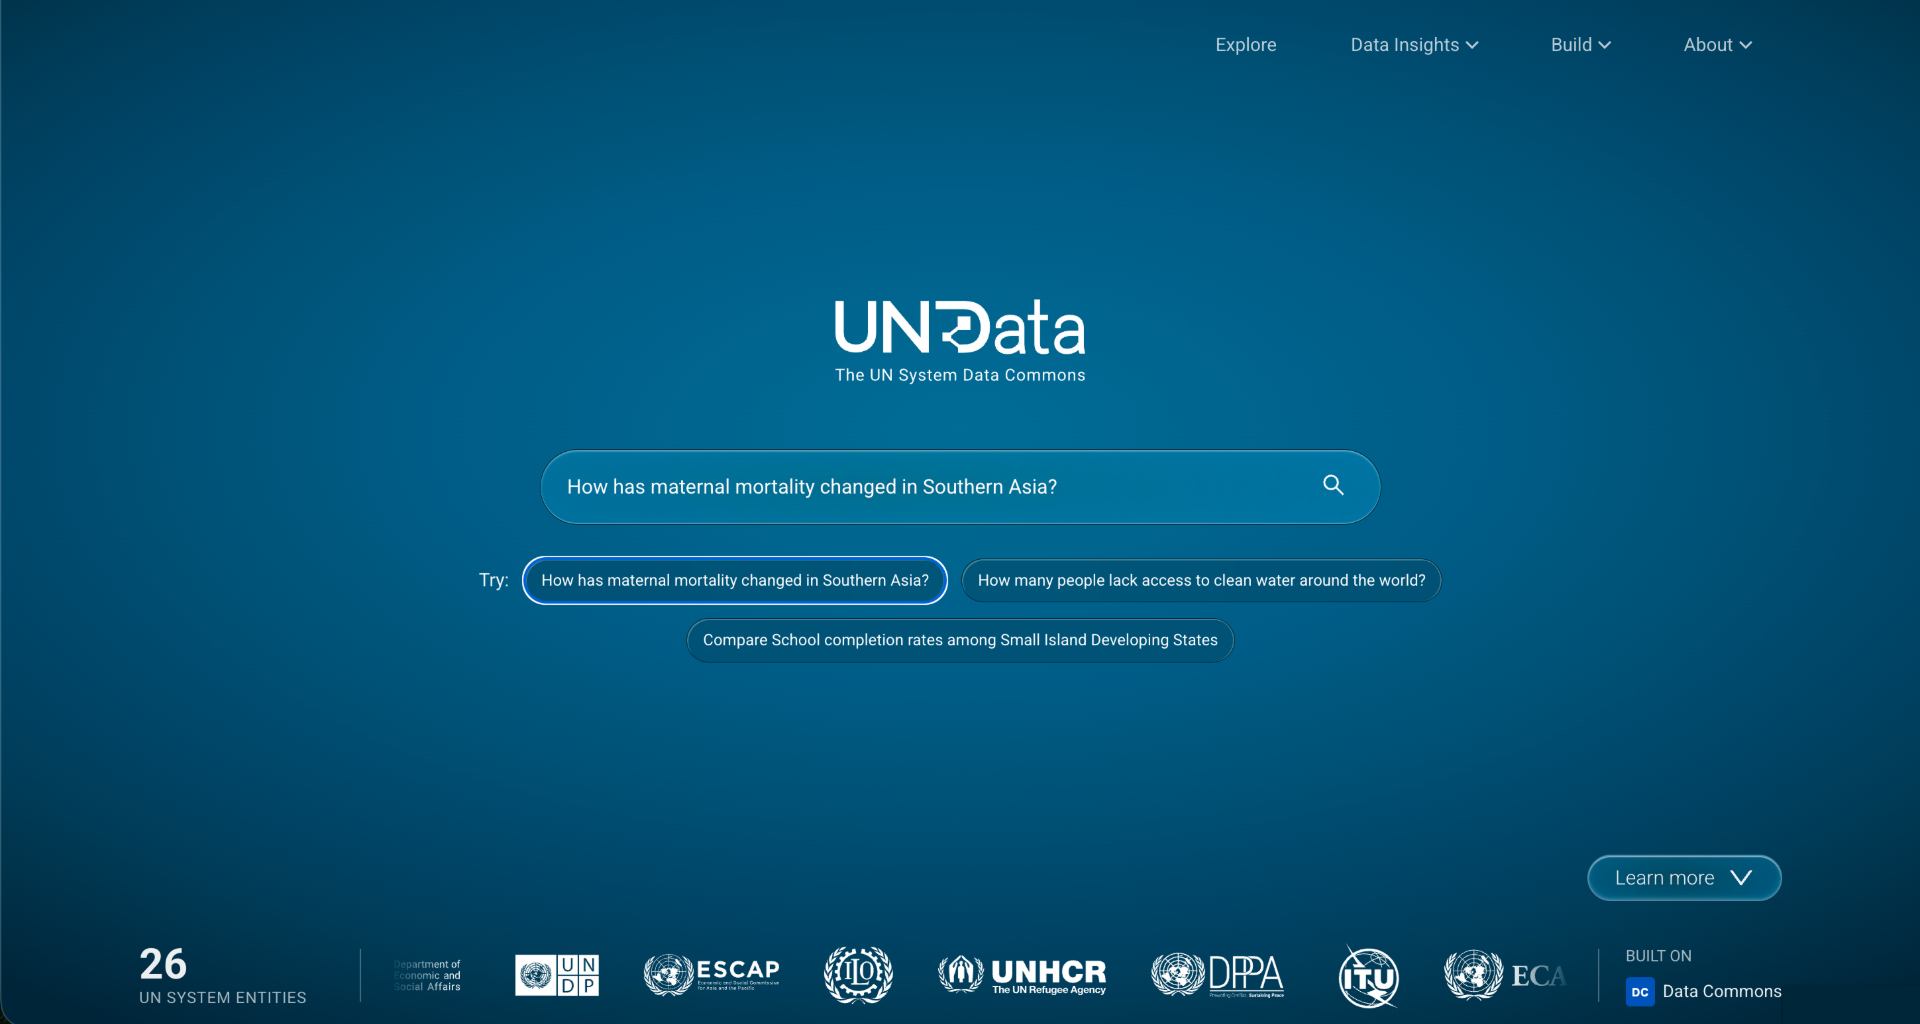 Giao diện UN System Data Commons
Vì sao LHQ phải hành động?
Lý do thúc đẩy dự án này đến từ một thử nghiệm đáng lo ngại của UNICEF. Cơ quan này đã đánh giá sáu mô hình ngôn ngữ lớn qua hơn 133.000 câu trả lời liên quan đến các chỉ số phát triển toàn cầu, và kết quả chỉ đạt độ chính xác trung bình 21,2%.
Ông João Pedro Azevedo, chuyên gia thống kê trưởng của UNICEF, cho biết thử nghiệm bao gồm GPT-4o và GPT-4o-mini của OpenAI, Claude Sonnet 4.5 và Haiku 4.5 của Anthropic, cùng Gemini 2.5 Flash và Gemini 2.0 Flash của Google.
Khoảng ba trong số năm câu trả lời không đưa ra được con số nào hữu ích, thường là do mô hình né tránh hoặc trả lời mập mờ.
Đáng chú ý hơn, khi chạy lại cùng bộ câu hỏi trên cùng phiên bản mô hình sau khoảng hai ngày, những mô hình đưa ra con số ở cả hai lần chỉ trả về kết quả giống hệt nhau trong khoảng một nửa trường hợp. Nghiên cứu này là một bản thảo đang được chuẩn bị để gửi đăng tạp chí và chưa qua bình duyệt.
Lưu lượng truy cập từ AI tăng vọt
UNICEF cũng ghi nhận lưu lượng truy cập từ các trợ lý AI tạo sinh vào website dữ liệu của mình tăng mạnh trong năm nay. Trang này đón hơn 6 triệu lượt truy cập mỗi tháng và là một trong những website phổ biến nhất của cơ quan.
Theo ông Azevedo, lượt truy cập từ người dùng nhấp vào liên kết trong câu trả lời của ChatGPT đã tăng 67% so với cùng kỳ trong giai đoạn từ ngày 1/1 đến 14/9. Các lượt giới thiệu này chiếm 6,4% tổng số phiên truy cập trong năm nay, và UNICEF ước tính các trợ lý AI nói chung hiện chiếm khoảng một phần mười tổng số lượt truy cập.
Mục tiêu mở rộng và vai trò của Google
Liên Hợp Quốc cho biết 26 thực thể đã cam kết tham gia Data Commons, với dữ liệu từ gần 20 cơ quan có sẵn ngay khi ra mắt. Mục tiêu đặt ra là đưa 80% bộ dữ liệu thống kê của toàn hệ thống LHQ lên nền tảng vào năm 2027.
Ông Shantanu Mukherjee, quyền giám đốc Phòng Thống kê LHQ, nhận định:
Chúng tôi đã tiến bộ vượt bậc về quy mô, phạm vi và tính linh hoạt, lần đầu tiên kết nối được nhiều cơ quan trong hệ thống LHQ đến vậy. Và chúng tôi tận dụng thời điểm này để đưa dữ liệu của mình trở nên sẵn sàng cho AI.
Google.org đã tài trợ 2 triệu USD cùng hỗ trợ kỹ thuật để xây dựng hạ tầng cốt lõi của nền tảng. Ông Prem Ramaswami, người đứng đầu nhóm Data Commons của Google, cho biết hệ thống được lưu trữ trên một phiên bản do LHQ quản lý và hướng tới việc LHQ sẽ tự vận hành, duy trì và mở rộng độc lập trong tương lai.
Google ra mắt Data Commons vào năm 2018 nhằm tổ chức các bộ dữ liệu công từ nhiều nguồn khác nhau vào một khuôn khổ chung. Năm ngoái, nền tảng này bổ sung hỗ trợ MCP, cho phép các tác nhân AI truy vấn trực tiếp số liệu và nguồn gốc của chúng.
Truy xuất nguồn gốc và giới hạn cần lưu ý
Nền tảng của LHQ còn theo dõi nguồn gốc của từng số liệu, giúp người dùng truy ngược dữ liệu mà hệ thống AI lấy được về nguồn gốc ban đầu của LHQ. Điều này được xem là quan trọng khi ngày càng nhiều người dựa vào công cụ AI để tìm kiếm và diễn giải thông tin.
Google cũng đã trình diễn cách một hệ thống AI kết nối với dữ liệu LHQ qua MCP có thể tổng hợp nhiều chỉ số và tạo ra bảng điều khiển, biểu đồ và phân tích bằng văn bản mà người dùng không cần tự tìm và kết hợp các bộ dữ liệu gốc. Trong một minh họa, Google yêu cầu AI tìm tác động của Kế hoạch Cứu trợ AIDS khẩn cấp của Tổng thống Mỹ (PEPFAR) tại châu Phi, và hệ thống đã xác định các số liệu LHQ liên quan như ca nhiễm HIV, tỷ lệ tử vong do AIDS và tuổi thọ để tạo ra một đồ họa thông tin.
Tuy nhiên, ông Ramaswami cũng đưa ra cảnh báo quan trọng:
Vì mô hình có thể diễn giải sai các sắc thái tinh tế, con người luôn nên kiểm tra lại kết quả đầu ra trước khi trích dẫn hoặc công bố.
Nói cách khác, việc cung cấp dữ liệu chính thống cho AI không đồng nghĩa với việc kết luận của nó cũng chính thống. Với người dùng Việt Nam — đặc biệt là các nhà nghiên cứu, nhà báo và chuyên gia phân tích chính sách thường xuyên tra cứu số liệu quốc tế — đây vừa là cơ hội để tiếp cận dữ liệu LHQ nhanh chóng hơn, vừa là lời nhắc nhở về việc luôn kiểm chứng nguồn trước khi sử dụng.