Mô hình 4B học tăng cường đánh bại GPT-6 Astra khi điều khiển Tesla Roadster bay trong bão
SkyPilot xây dựng môi trường học tăng cường quanh trình mô phỏng vật lý chiếc Tesla Roadster bay, rồi giao quyền điều khiển cho các mô hình ngôn ngữ lớn. Kết quả: các mô hình hàng đầu như GPT-6 Astra gần như vô dụng khi phải ra quyết định theo thời gian thực, còn một mô hình Qwen3-4B được tinh chỉnh bằng RL trong khoảng 13 USD lại hạ cánh thành công 90% cú kickflip trong bão — vượt GPT-6 Astra tới 21%.
Mô hình 4B sau huấn luyện RL hạ cánh Tesla Roadster bay tốt hơn GPT-6 Astra tới 21%
Các mô hình ngôn ngữ lớn đắt tiền nhất hiện nay thất bại thảm hại khi được giao lái một chiếc Tesla Roadster bay trong điều kiện thời tiết thực tế. Trong khi đó, một mô hình 4B tham số được học tăng cường (RL) hậu huấn luyện với chi phí chỉ khoảng 13 USD lại hạ cánh thành công 90% số cú kickflip trong bão, vượt cả GPT-6 Astra lẫn DeepSeek V4.1 Flash.
Thử nghiệm do nhóm SkyPilot thực hiện, đặt ra một câu hỏi rất đáng suy ngẫm cho cộng đồng AI: liệu điểm benchmark có còn ý nghĩa khi mô hình phải ra quyết định trong lúc thế giới vẫn đang chuyển động?
 Mô hình 4B được huấn luyện bằng học tăng cường điều khiển Tesla Roadster bay
Bối cảnh: khi xe bay cần quyết định mỗi 0,2 giây
Hôm 15/10, Tesla công bố màn trình diễn Roadster thế hệ mới: xe lao lên một đoạn dốc cong ngược, lộn nhào trên không rồi tiếp đất, sau đó dùng động cơ đẩy nhảy qua một chiếc Cybertruck. Màn demo từng bị hoãn hai tuần "do gió lớn", theo Elon Musk trên X — chi tiết này đã truyền cảm hứng cho thử nghiệm.
Nhóm SkyPilot dựng một trình mô phỏng vật lý của chiếc Roadster bay với bốn động cơ đẩy khí lạnh ở bốn góc sàn xe, mỗi động cơ lực đẩy 12 kN, mô phỏng ở tần số 500 Hz. Xe được giả lập là một vật thể rắn dài 4,5 m, nặng 2.000 kg, chịu tác động của gió giật theo ba cấp: nhẹ (tới 14 m/s), gió mạnh (14–24 m/s) và bão (24–33 m/s).
Mô hình ngôn ngữ nhận một dòng dữ liệu cảm biến mỗi 0,2 giây và trả về một lệnh JSON trong số năm lệnh: bay lượn (coast), bay lên (climb), giữ thăng bằng (hold), xoay (rotate) và hạ cánh (land). Một máy tính bay sẽ chuyển lệnh đó thành lực đẩy cho từng động cơ, 50 lần mỗi giây.
Hai bài thi chính mô phỏng màn trình diễn thật: cú lộn từ dốc (ramp flip — xe rời dốc ở tư thế lật ngược, cách mặt đất 10–14 m, phải xoay lại và hạ cánh) và cú kickflip qua Cybertruck (xe lao tới với vận tốc 50–94 km/h, xoay trọn 360 độ trên không rồi tiếp đất).
Kết quả gây sốc: mô hình lớn "bó tay" vì quá chậm
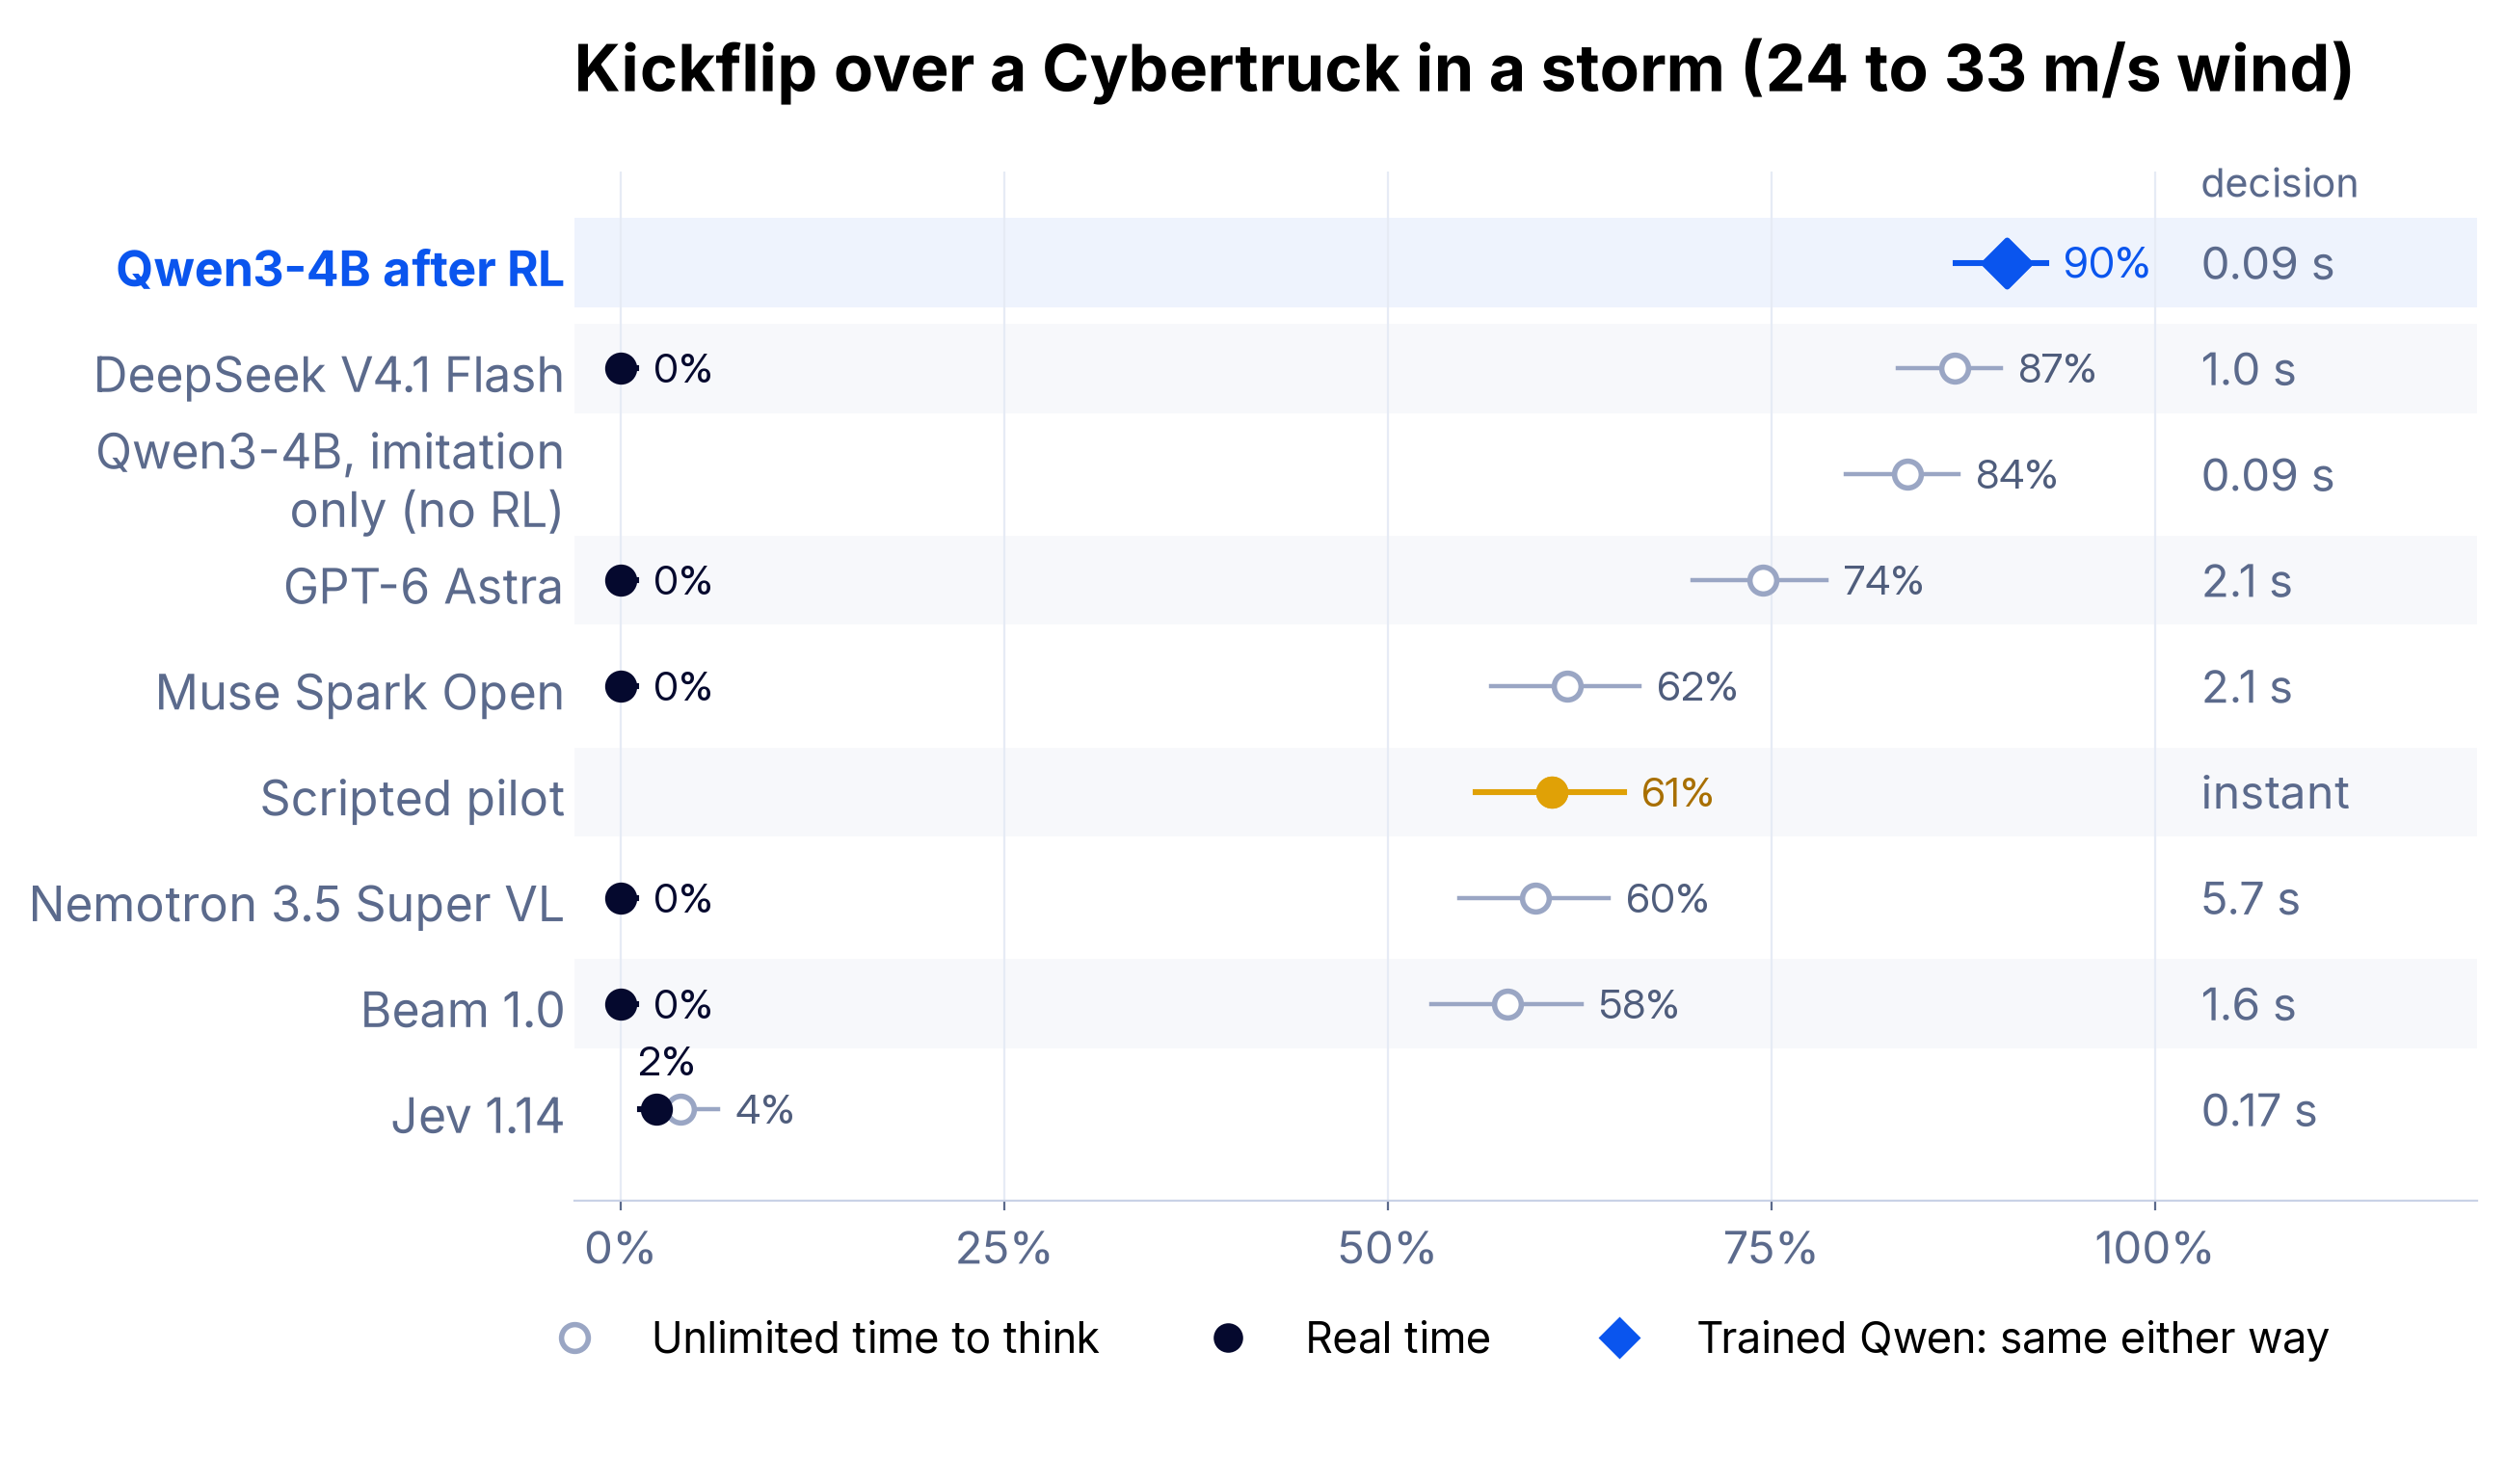
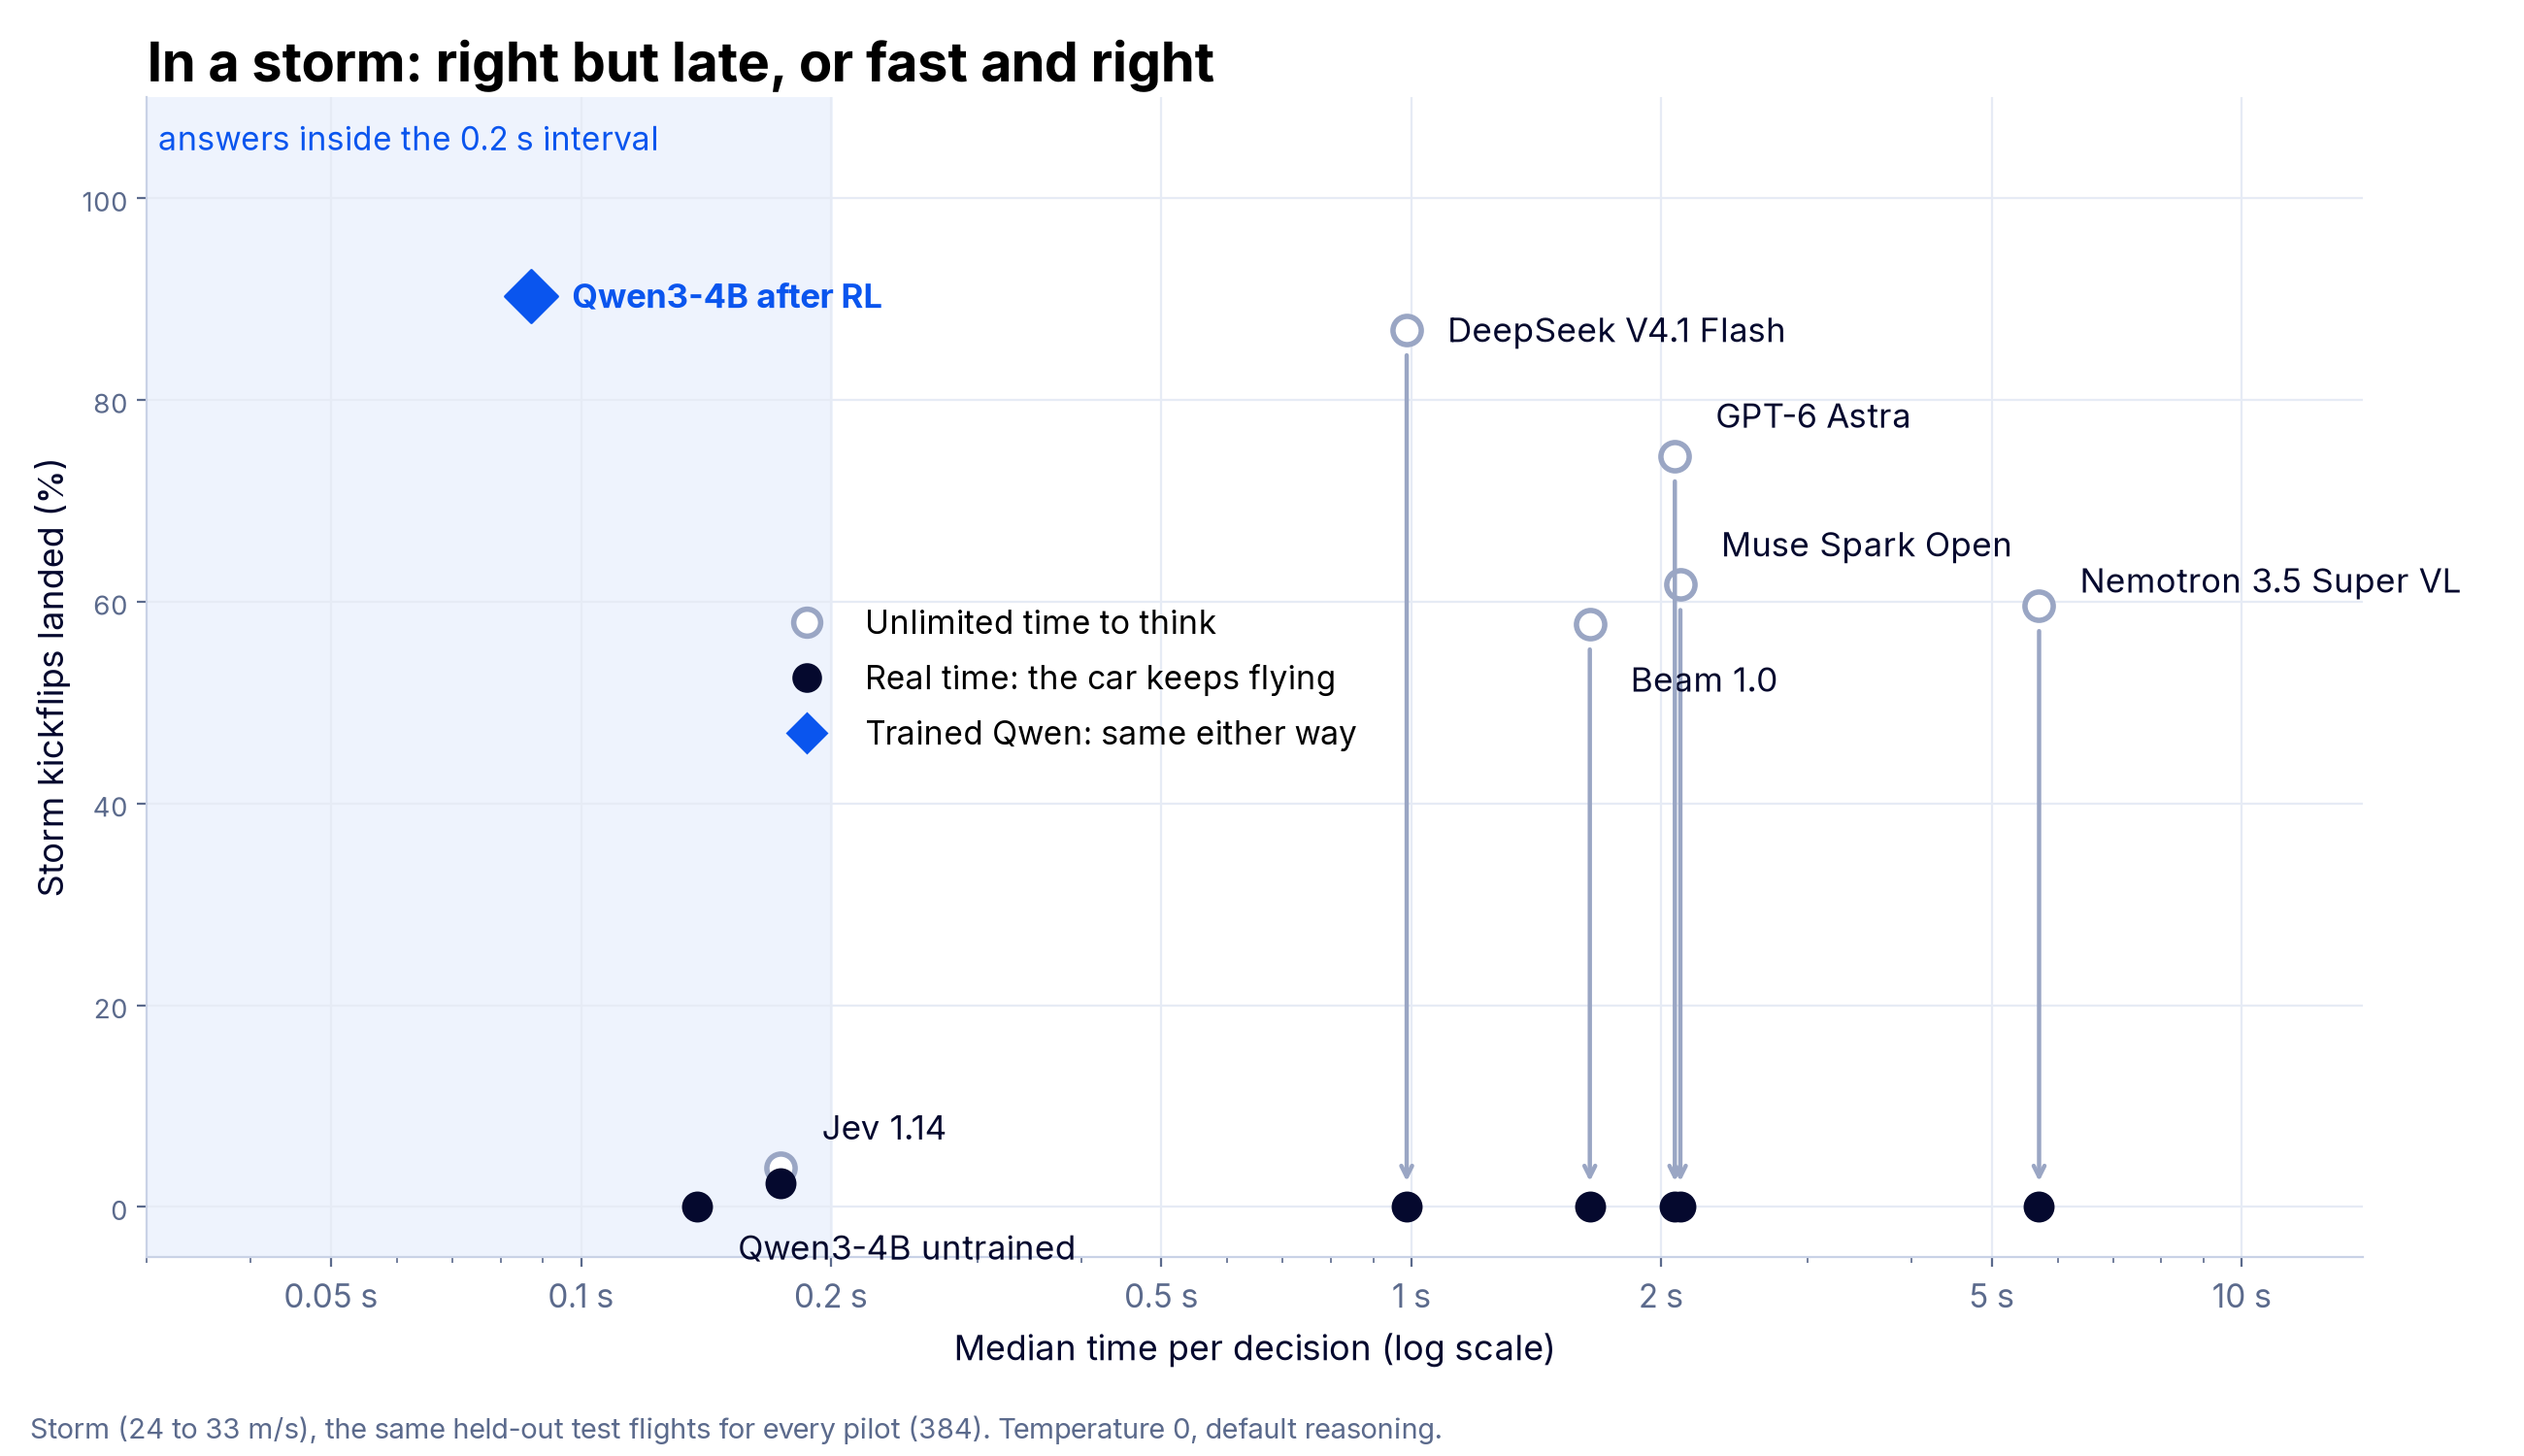
Với thời gian suy nghĩ không giới hạn (tạm dừng trình mô phỏng chờ mô hình trả lời), các mô hình mở hàng đầu vẫn bay khá tốt. DeepSeek V4.1 Flash hạ cánh 98% cú kickflip trong gió nhẹ và 87% trong bão. Các mô hình Muse Spark Open, Nemotron 3.5 Super và Beam 1.0 đạt 58–82%. GPT-6 Astra đạt 74% trong bão.
Nhưng khi đồng hồ chạy thật, bức tranh đảo ngược hoàn toàn:
- DeepSeek V4.1 Flash, Muse, Nemotron và Beam: hạ cánh 0% số cú kickflip thời gian thực, do mỗi quyết định mất từ 1 đến 6 giây.
- GPT-6 Astra: khoảng 2 giây mỗi quyết định, hạ cánh 0/768 chuyến bay trong bão theo thời gian thực.
- Qwen3-4B sau RL: trả lời trong 0,09 giây, hạ cánh 90% cú kickflip trong bão.
Một mô hình 4B tham số hoàn toàn có thể đánh bại những mô hình hàng trăm tỷ tham số — miễn là nó được huấn luyện đúng cách cho đúng nhiệm vụ.
Điều đáng chú ý: mô hình Jev 1.14 của TypeSafe trả lời đủ nhanh (khoảng 0,17 giây) nhưng chỉ hạ cánh 2% số chuyến trong bão. Nghĩa là vừa phải nhanh, vừa phải ra quyết định đúng — tốc độ đơn thuần không cứu được.
 So sánh tỷ lệ hạ cánh thành công giữa các mô hình theo cấp độ gió
Bí quyết: khởi động ấm rồi tinh chỉnh bằng RL
Nhóm nghiên cứu bắt đầu từ Qwen3-4B-Instruct-2507 gắn LoRA rank-64, dùng thư viện mã nguồn mở SkyRL. Quá trình huấn luyện chia làm hai giai đoạn:
- Khởi động ấm (2 giờ 20 phút): học có giám sát trên các chuyến bay hạ cánh thành công, kết hợp hai "giáo viên" — phi công viết tay bằng quy tắc (giỏi trong gió nhẹ) và DeepSeek V4.1 Flash với thời gian suy nghĩ không giới hạn (giỏi trong bão). Việc chọn giáo viên theo cấp gió là điểm mấu chốt.
- Học tăng cường (1 giờ 35 phút): dùng GRPO, mỗi bước bay 16 nhiệm vụ, mỗi nhiệm vụ 8 chuyến, tổng cộng 60 bước. Phần thưởng từ 0 đến 1, trong đó 0,4 dành cho hạ cánh thành công và 0,1 cho cú tiếp đất êm, còn dư khí và đúng tâm đường.
Tổng chi phí: khoảng 4 giờ GPU H100, tương đương 13 USD. Kết quả sau RL:
| Bài thi | Gió nhẹ | Gió mạnh | Bão |
|---|---|---|---|
| Kickflip – Qwen3-4B sau RL | 96% | 96% | 90% |
| Kickflip – DeepSeek V4.1 (không giới hạn thời gian) | 98% | 90% | 87% |
| Kickflip – GPT-6 Astra (không giới hạn thời gian) | — | — | 74% |
| Lộn dốc – Qwen3-4B sau RL | 100% | 100% | 98% |
Đối chiếu trực tiếp trên 384 chuyến kickflip trong bão: mô hình 4B hạ cánh 347 chuyến, GPT-6 Astra chỉ 286 — tức nhiều hơn 21%. Có 70 chuyến chỉ mình mô hình 4B hạ cánh được, và chỉ 9 chuyến chỉ Astra làm được (kiểm định cặp chính xác, p < 0,001).
Bài học cho ngành AI Việt Nam và thế giới
Nhóm tác giả rút ra bốn bài học lớn:
- Mô phỏng phải phản ánh kịch bản thực tế. Cùng một bộ chuyến bay, thứ hạng đảo ngược hoàn toàn giữa chế độ "tạm dừng" và "thời gian thực". Hầu hết benchmark LLM hiện nay cho mô hình bao nhiêu thời gian tùy thích — điều này che giấu điểm yếu chí mạng với các ứng dụng như xe tự hành hay trợ lý giọng nói.
- Mô hình nhỏ nhưng huấn luyện đúng quan trọng hơn mô hình to. DeepSeek chỉ chạy 16B trong tổng 552B tham số mỗi token, đánh bại cả Muse Spark Open (42B/816B) và Beam 1.0 (23B/501B). Trên một nhiệm vụ hẹp, cách huấn luyện quyết định hơn số tham số được kích hoạt.
- RL đưa mô hình vượt qua chính các giáo viên của nó. Sau khởi động ấm, mô hình 4B đạt ngang giáo viên; sau RL, nó hạ cánh thêm 25 chuyến bão trong 384 chuyến, chỉ 1 chuyến đi ngược lại.
- GRPO cần các lần thử khác nhau ở quyết định khó. Khi cả 8 chuyến trong nhóm đều hỏng giống nhau, phần thưởng bằng nhau và mô hình không học được gì. Đây là lỗi rất dễ mắc khi thiết kế môi trường RL.
 Giao diện thử nghiệm cho phép chạy mô hình của riêng bạn trên môi trường mô phỏng
Giới hạn cần lưu ý
Nhóm tác giả thẳng thắn thừa nhận thử nghiệm này không nói lên điều gì về việc lái xe bay thật. Một chiếc xe thật sẽ dùng bộ điều khiển truyền thống, và ngay cả phi công viết tay của họ cũng ra quyết định tức thời — điều không LLM nào làm được. Các hệ thống robot thực tế như Helix của Figure chạy mô hình thị giác-ngôn ngữ 7B ở tần số 7–9 Hz trên nền một policy 80 triệu tham số chạy 200 Hz. Ngoài ra, DeepSeek từng là một phần của dữ liệu khởi động ấm, nên trong bão, mô hình 4B đang được so với chính "người thầy" mà nó học theo.
Toàn bộ mã nguồn, môi trường RL và quy trình huấn luyện đều mở, bạn có thể tự chạy mô hình của mình mà không cần GPU thông qua SkyPilot Tokens.
Với cộng đồng AI tại Việt Nam, thử nghiệm này là lời nhắc đáng giá: đừng chỉ chạy theo mô hình lớn nhất. Một mô hình nhỏ, được tinh chỉnh đúng bài toán và đo lường đúng môi trường triển khai, có thể mang lại kết quả vượt trội với chi phí chỉ bằng một bữa ăn.