Mô hình học máy giúp đọc chữ trên cuộn giấy cói 2.000 năm tuổi
Hai người tham gia Thử thách Vesuvius đã dùng ảnh chụp cắt lớp vi tính siêu nhỏ và mô hình học máy để nhận diện chữ viết trên cuộn giấy cói PHerc. 306B, lần đầu tiên sau khoảng 2.000 năm. Phát hiện giúp xác định vị trí của phần cuộn giấy và mở ra cơ hội đọc thêm các bản thảo bị carbon hóa từ thời La Mã.
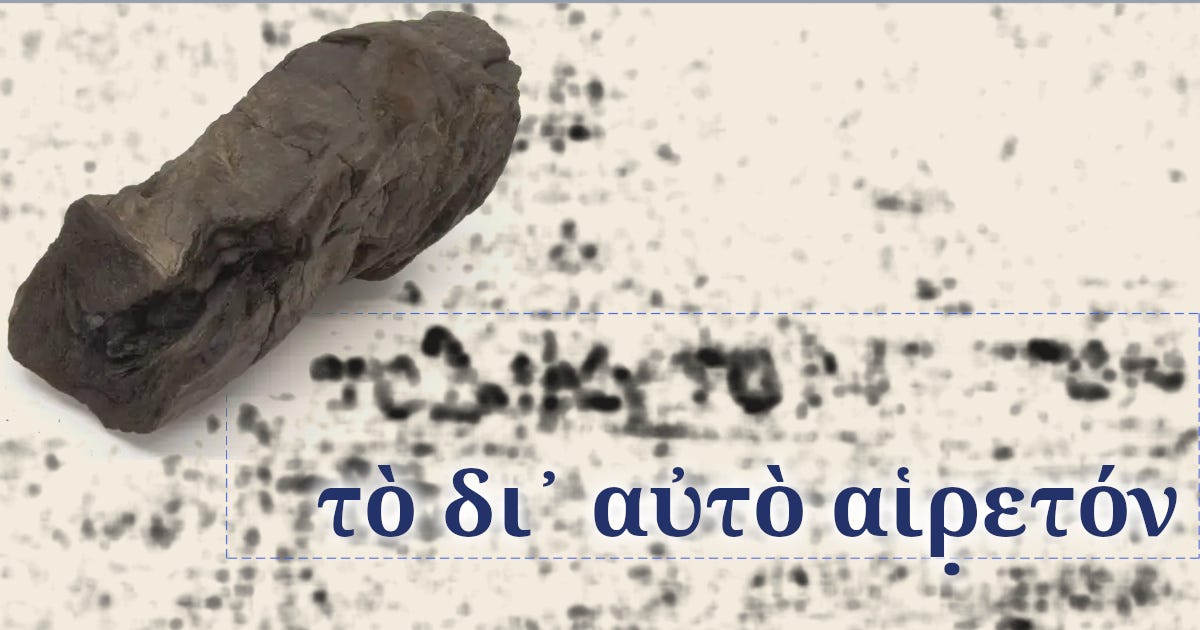
Hai người tham gia Thử thách Vesuvius đã dùng học máy để nhận diện chữ viết trên PHerc. 306B, cuộn giấy cói bị chôn vùi sau vụ phun trào núi Vesuvius năm 79. Đây là lần đầu tiên nội dung trên phần cuộn này được đọc sau khoảng 2.000 năm, đồng thời cho thấy các mô hình xử lý ảnh có thể hỗ trợ khôi phục văn bản cổ mà không cần mở cuộn giấy vật lý.
Liam Warner và Nicola Bodill giành giải thưởng First Letters trị giá 50.000 USD nhờ tìm được ít nhất 10 ký tự có thể đọc trong một vùng rộng 4 cm². Nhóm tổ chức cho biết họ đã xem xét 25 bài dự thi về cuộn giấy này.
Nhận diện phần trên của cuộn giấy
PHerc. 306 bị chia thành hai phần, được gọi là PHerc. 306A và PHerc. 306B. Trước phát hiện mới, các nhà nghiên cứu chưa xác định được phần nào tương ứng với đầu trên hay đầu dưới của cuộn nguyên bản. Dựa trên vị trí mực và hướng chữ viết, nhóm nghiên cứu kết luận PHerc. 306B là phần trên, còn PHerc. 306A nhỏ hơn là phần dưới.
Cuộn giấy được khai quật từ thập niên 1750 tại Villa dei Papiri ở Herculaneum, sau đó được chụp bằng chụp cắt lớp vi tính siêu nhỏ (micro-CT), kỹ thuật tạo ảnh các lát cắt bên trong vật thể. PHerc. 306B hiện được lưu giữ tại Thư viện Quốc gia Napoli, cách địa điểm khai quật khoảng 10 km.
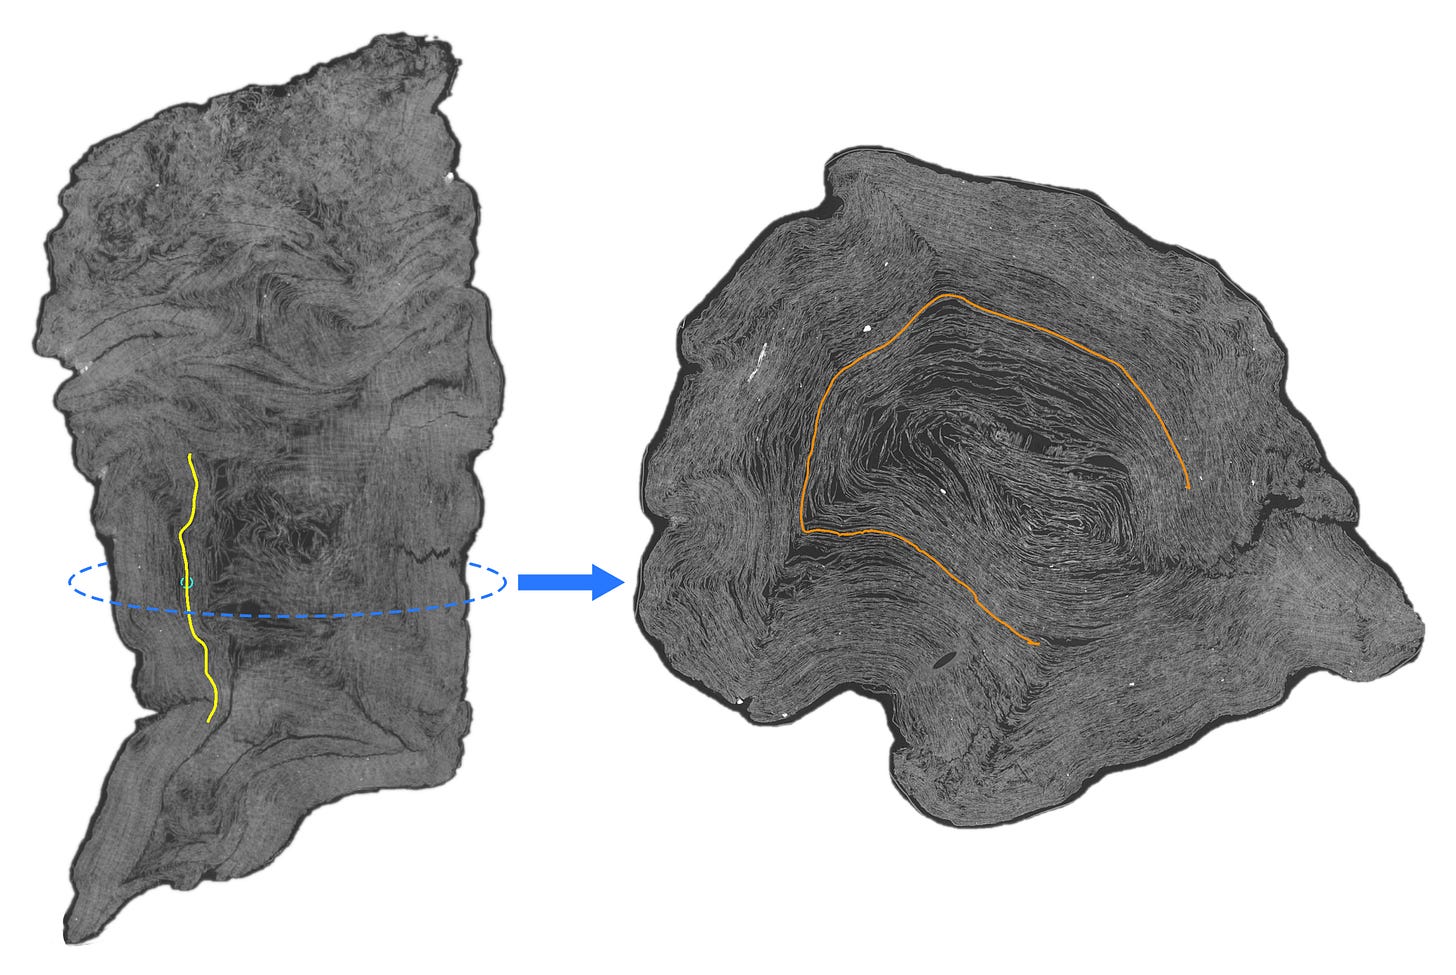 Ảnh minh họa quá trình tái dựng cuộn giấy cói bằng dữ liệu quét
Từ nét mực mờ đến cách đọc thống nhất
Nhiều nhóm dự thi đã tìm thấy cùng một vùng chữ và nhận diện được một chuỗi ký tự tương ứng với “to diauto”. Tuy nhiên, các nét tiếp theo quá mờ để nhóm chuyên gia về bản thảo cổ thống nhất cách đọc. Phần chữ gây tranh luận có thể là một ký tự tương ứng với M, N hoặc tổ hợp hai chữ cái AI — những hình dạng dễ nhầm lẫn trong lối viết chữ hoa thời cổ.
Hình ảnh do Warner và Bodill xử lý làm lộ rõ nét giữa của chữ cái, giúp các chuyên gia lần đầu đồng thuận rằng phần này là tổ hợp AI. Từ đó, cụm từ được diễn giải là “điều đáng mong muốn tự thân”. Cách đọc này có những điểm tương đồng trong các tác phẩm triết học của Aristotle, Sextus Empiricus và chuyên luận Bàn về cơn giận của Philodemus.
Trước bài dự thi đoạt giải, một số nhóm chỉ nhận diện được 7, 8 hoặc 9 ký tự, chưa đạt tiêu chí. Nhóm tổ chức ghi nhận nỗ lực của The Gold Panners, Grilli Security Research Team, Matteo Bulloni, Clovis Hublin, TAUIL-Abd-Elilah, Ben Kyles và các cộng sự, Les Copronautes cùng Doom Scrollers.
Kết hợp dữ liệu quét và nhiều mô hình học máy
Để cô lập lớp giấy cói chứa chữ bên trong ảnh quét ba chiều, nhóm sử dụng công cụ GrowPatch của VC3D trên các dự đoán bề mặt m7 do đội Thử thách Vesuvius công bố. Vị trí bắt đầu được chọn dựa trên một đường xoắn tìm bằng công cụ spiral-fitter công khai; đầu bên phải của vùng được chỉnh theo các dự đoán bề mặt m7.
Bản đồ nhận diện mực cuối cùng được tạo bằng cách nhân đầu ra của hai mô hình. Một điểm ảnh chỉ được đánh dấu là mực khi cả hai mô hình cùng nhận diện. Mô hình thứ nhất là TRACE v3B, do Jashanjot Singh Gill và Nhat Nam Tran công bố. Mô hình thứ hai, A-hn, được Warner và Bodill tinh chỉnh từ v8-in của Youssef Nader — mô hình từng được dùng để phát hiện những chữ đầu tiên trên PHerc. 1447.
A-hn là kết quả trung bình của ba lượt huấn luyện, mỗi lượt 600 bước. Dữ liệu huấn luyện gồm một nửa nhãn trên PHerc. 1447 do Nader tạo và một nửa nhãn máy trên các vùng khác của PHerc. 0306B. Phần nhãn máy được tạo bằng cách lấy trung bình dự đoán của bốn mô hình công khai: v8-in, Reader v3, Reader v2 và TRACE v3B. Quá trình huấn luyện còn bổ sung mức phạt khi mô hình đánh dấu giấy cói trống thành mực.
Warner là kỹ sư phần mềm tư vấn tự do ở miền bắc nước Anh, từng làm việc trong lĩnh vực trò chơi điện tử, y tế và công nghệ phát thanh truyền hình. Bodill đến từ Australia, có bằng cử nhân tiếng Latin và tiếng Hy Lạp cổ, đồng thời đang học cao học tại Đại học Sydney. Từ năm 2023, cô đã dành hàng trăm giờ tạo nhãn mực thủ công để huấn luyện mô hình.
Còn 20 cuộn giấy chờ được giải mã
Sau phát hiện này, còn 20 cuộn giấy đủ điều kiện nhận giải First Letters đã được quét nhưng chưa có đủ văn bản đọc được. PHerc. 306B cũng trở thành ứng viên nổi bật cho giải thưởng lớn trị giá 800.000 USD, dành cho đội đầu tiên có thể mở cuộn giấy bằng phương pháp ảo và đọc được 70% toàn bộ nội dung với mức can thiệp thủ công tối thiểu.
Nhóm tổ chức cho biết đã nhận bài dự thi về 13 cuộn giấy khác, ngoài PHerc. 306B và PHerc. 0343 — cuộn mà Erwin Nieuwlaar đã có bài dự thi đoạt giải. Chưa bài nào trong số đó đáp ứng yêu cầu nhận thưởng. Một mục tiêu tiếp theo là cải thiện độ tin cậy của việc phát hiện mực trên ảnh quét có độ phân giải 8–9 micromét, vốn được đánh giá là tương đối khả thi và có chi phí hợp lý để thu thập.
Góc nhìn
Kết quả cho thấy việc kết hợp ảnh quét ba chiều, dữ liệu gán nhãn và nhiều mô hình học máy có thể giúp phục hồi thông tin từ những vật thể không thể đọc trực tiếp. Trong trường hợp này, cải thiện một nét nhỏ đã đủ để chuyển cách đọc từ bất định sang có sự đồng thuận của chuyên gia.
Với các nhóm phát triển phần mềm và học máy, dự án cũng là ví dụ về quy trình có thể kiểm chứng và tiếp tục xây dựng: công cụ, mô hình và dữ liệu đều được công bố. Cách làm này giúp cộng đồng thử nghiệm, so sánh kết quả và cải thiện khả năng nhận diện trên những cuộn giấy khác.
Nguồn: scrollprize.substack.com · Quy trình biên tập