Nén texture bằng AI không cần lan truyền ngược: Thí nghiệm Evolution Strategies của Rich Geldreich
Lập trình viên đồ họa Rich Geldreich công bố dự án neural_texture_es2, một thí nghiệm C++ huấn luyện bộ giải mã texture nơ-ron và vật liệu PBR hoàn toàn bằng Evolution Strategies, không dùng backprop hay autodiff. Kết quả đạt 32,2 dB ở 3,27 bpp cho ảnh đơn và nén trọn bốn lớp vật liệu PavingStones070 chỉ với 0,66 bpp mỗi texture.
Nén texture bằng AI không cần lan truyền ngược: Thí nghiệm Evolution Strategies của Rich Geldreich
Trong thế giới nén texture nơ-ron, gần như mọi giải pháp đều dựa vào lan truyền ngược để huấn luyện bộ giải mã. Nhưng Rich Geldreich — tác giả của nhiều công cụ nén texture nổi tiếng — vừa chứng minh một hướng đi hoàn toàn khác: dùng Evolution Strategies (ES) để huấn luyện cả latent texture lẫn MLP decoder mà không cần một dòng autodiff nào.
Dự án mang tên neural_texture_es2, công bố ngày 4 tháng 9 năm 2026, là một thí nghiệm C++ nhỏ gọn, tự chứa, cho thấy tiềm năng to lớn của phương pháp tối ưu không đạo hàm trong lĩnh vực nén vật liệu đồ họa.
Bài toán: nén texture truyền thống đã chạm trần
Các định dạng nén texture trên GPU như BC1–BC7 hay ASTC đã phục vụ ngành game hơn hai thập kỷ, nhưng chúng đang dần chạm giới hạn về tỷ lệ nén. Nén texture nơ-ron (neural texture compression) xuất hiện như một giải pháp thay thế: thay vì lưu trực tiếp pixel, ta lưu một latent texture độ phân giải thấp cùng một mạng nơ-ron nhỏ để giải mã ra texture gốc.
Công thức cốt lõi của phương pháp này rất đơn giản:
I(u,v) ≈ MLP( bilinear(Z, u, v), phi(u,v) )
Trong đó Z là latent texture, phi là positional encoding, và MLP sẽ tái tạo màu sắc tại mỗi tọa độ UV. Về lý thuyết, cách này cho tỷ lệ nén vượt trội so với các codec truyền thống.
Vấn đề nằm ở chỗ: hầu hết các phương pháp đều cần lan truyền ngược để huấn luyện, kéo theo yêu cầu về framework học sâu, bộ nhớ GPU và một pipeline phức tạp. Geldreich đặt câu hỏi: liệu có thể bỏ hoàn toàn backprop mà vẫn đạt kết quả tương đương?
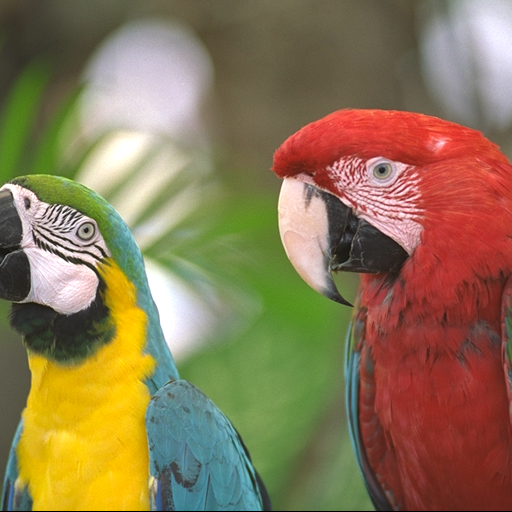 Ảnh gốc dùng làm mục tiêu huấn luyện
Evolution Strategies thay cho đạo hàm
Ý tưởng nền tảng của Evolution Strategies khá trực quan: thay vì tính gradient bằng giải tích, ta chỉ cần đo giá trị hàm mất mát. Với mỗi bước, thuật toán tạo ra các cặp nhiễu đối xứng (antithetic perturbation), đánh giá mất mát ở cả hai phía +ε và −ε, rồi ước lượng gradient từ chênh lệch đó.
Cách tiếp cận này có một lợi thế lớn: nó chỉ quan sát giá trị loss, không quan tâm bên trong có gì. Điều đó nghĩa là bất kỳ bộ lượng tử hóa (quantizer) hay codec không khả vi nào cũng có thể nằm trong vòng lặp huấn luyện mà không cần straight-through estimator hay surrogate khả vi.
Tuy nhiên, ES ngây thơ có một nhược điểm chí mạng: phương sai tăng theo số lượng tham số. Với latent texture 131.000 giá trị, tín hiệu mất mát từ mỗi texel bị chôn vùi dưới hàng nghìn hiệu ứng cục bộ khác. Đây chính là điểm mà Geldreich giải quyết bằng một kỹ thuật thông minh.
Điểm đột phá: quy kết theo vùng phủ (footprint attribution)
Thay vì coi toàn bộ thay đổi loss là tổng của mọi tham số, tác giả lợi dụng cấu trúc phụ thuộc không gian đã biết của bộ giải mã. Cụ thể:
- Tất cả giá trị latent được nhiễu đồng thời
- Ảnh được giải mã hai lần cho +ε và −ε
- Thay đổi loss của mỗi pixel chỉ được quy cho tối đa 4 texel mà phép lấy mẫu song tuyến tính của pixel đó đọc tới
Nói cách khác, nhiễu từ khoảng 16.000 texel khác bị loại bỏ thay vì bị lấy trung bình. Nhờ đó, chỉ với 4 cặp nhiễu mỗi bước, ES trở nên khả thi trên latent có 131.000 giá trị.
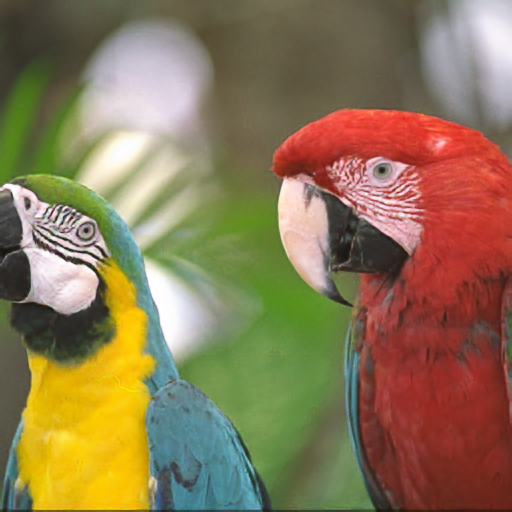 Tái tạo từ latent lượng tử hóa 8 bit, đạt 32,2 dB
Tác giả nhấn mạnh rằng đây là cơ chế giảm phương sai không thiên lệch: với một giá trị latent cho trước, các số hạng loss bị bỏ qua không phụ thuộc vào nhiễu của nó, nên kỳ vọng của tích bằng không. Việc quy kết theo footprint chỉ đơn thuần vứt bỏ chúng — một hệ quả trực tiếp từ đồ thị phụ thuộc của bộ giải mã.
Kết quả thực nghiệm
Với ảnh kodim23 (bộ ảnh chuẩn Kodak), cắt còn 512×512, huấn luyện 3000 vòng lặp:
- Latent 64×64×4: 26,9 dB ở 0,47 bpp (mã hóa entropy)
- Latent 64×64×8: 28,2 dB ở 0,87 bpp
- Latent 128×128×4: 30,3 dB ở 1,65 bpp
- Latent 128×128×8: 32,2 dB ở 3,27 bpp
Lượng tử hóa latent xuống 8 bit chỉ mất khoảng 0,04 dB — một mức tổn thất gần như không đáng kể. Đáng chú ý hơn, toàn bộ quá trình huấn luyện chạy trong khoảng 150 giây trên CPU 32 luồng, không cần GPU.
Nén trọn vật liệu PBR bốn lớp
Điểm ấn tượng nhất của dự án là khả năng nén cả một vật liệu PBR từ một latent dùng chung. Vật liệu PavingStones070 gồm bốn lớp — normal map, roughness, albedo và ambient occlusion — được huấn luyện đồng thời từ một latent 128×128×4 + 64×64×4 và một MLP 10→36→36→12 (2172 trọng số).
Kết quả với latent 8 bit:
- Normal map: 23,2 dB
- Roughness: 31,5 dB
- Albedo: 23,2 dB
- Ambient occlusion: 29,6 dB
- Tổng bitrate: 2,64 bpp, tương đương 0,66 bpp cho mỗi texture
Mấu chốt kỹ thuật nằm ở chỗ loss của mỗi pixel được cộng dồn qua tất cả các kênh của mọi texture trước khi quy kết footprint. Nhờ vậy, chỉ một cặp giải mã đối xứng của toàn bộ vật liệu đã tạo ra ước lượng ES cho mọi texel latent, đồng thời tính đến tất cả các texture. Trọng số loss theo từng texture cũng được đưa vào trước bước quy kết, nên đặt trọng số bằng 0 sẽ loại bỏ hoàn toàn ảnh hưởng của texture đó.
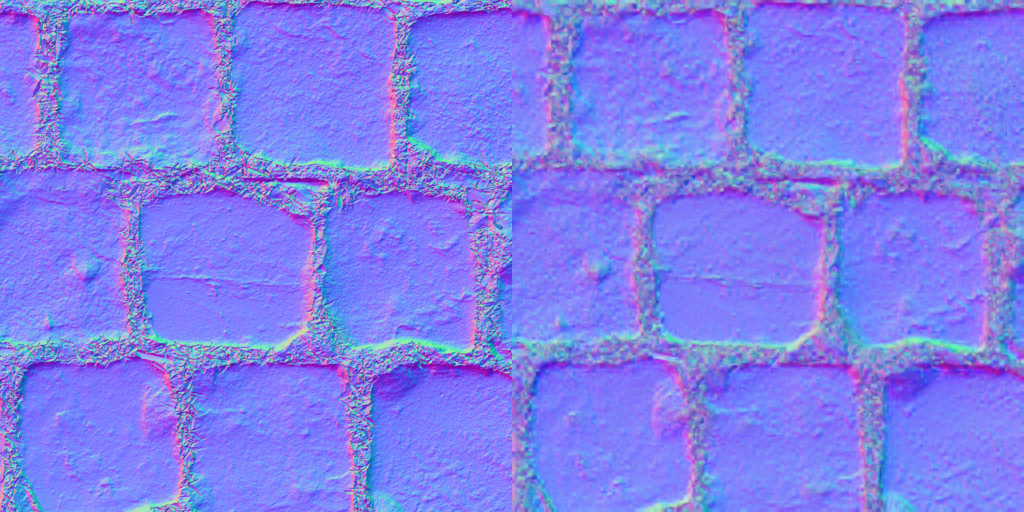 So sánh ảnh mục tiêu và ảnh tái tạo từ latent 8 bit
Những tinh chỉnh đáng chú ý
Trong phiên bản cập nhật ngày 4 tháng 9, tác giả bổ sung một số kỹ thuật quan trọng:
- Annealing learning rate: giảm dần tốc độ học trong nửa sau quá trình huấn luyện giúp loại bỏ hiện tượng nhiễu sàn, cải thiện 0,85 dB trên ảnh mario. Nguyên nhân là nhiễu gradient trong ES được bơm lại mỗi bước, khiến Adam với tốc độ học cố định bị kẹt ở một mức dao động.
- Finite differences cho decoder: giai đoạn cuối có thể chuyển MLP sang sai phân hữu hạn trung tâm theo từng trọng số, giúp tiết kiệm một nửa số vòng lặp so với chạy thông thường.
- Latent hai tầng: một latent thứ hai độ phân giải thô hơn được lấy mẫu cùng tọa độ UV và nối kênh vào tầng đầu.
- Hoán đổi nhiễu giữa các tầng (
--lat-alt): mỗi cặp chỉ nhiễu một tầng, luân phiên qua các bước, loại bỏ nhiễu chéo giữa hai tầng.
Hướng phát triển: nén trong miền đã mã hóa
Phần thú vị nhất của tài liệu có lẽ nằm ở các ý tưởng chưa triển khai, nhưng mang tính gợi mở cao:
- Huấn luyện nhận biết lượng tử hóa: đặt bộ lượng tử hóa hoặc codec block-compressed (BC/ASTC) ngay trong vòng lặp ES, để bộ huấn luyện "nhìn thấy" latent đúng như GPU sẽ đọc.
- Tìm kiếm trực tiếp trong biểu diễn đã mã hóa: biến chính texture đã nén thành vector tham số, dùng ES với nhiễu rời rạc hoặc stochastic coordinate descent để tối ưu trực tiếp các trường lưu trữ. Khi đó bitrate được cố định bởi định dạng, và trình huấn luyện chính là trình nén texture — với MLP nằm trong hàm distortion.
- Loss thông qua BRDF (rendering loss): đưa mô hình shading vào đánh giá ES, để mỗi bản đồ được đánh trọng số theo mức ảnh hưởng thực tế đến hình ảnh render — đúng những gì game thực sự nhìn thấy. Điều này không đòi hỏi đạo hàm của BRDF hay tone mapping.
- SPSA và Rademacher ES: tác giả chỉ ra rằng SPSA của Spall về bản chất chính là ES đối xứng với hướng nhiễu ±1 thay vì Gaussian, nên có thể tích hợp vào cơ chế footprint attribution mà không cần thay đổi gì.
Góc nhìn cho cộng đồng phát triển game Việt Nam
Với các studio game tại Việt Nam — nơi tài nguyên GPU thường là ràng buộc lớn — hướng tiếp cận này đặc biệt đáng quan tâm. Việc huấn luyện chỉ trên CPU, không cần framework học sâu, và có thể mở rộng sang các định dạng nén GPU tiêu chuẩn đồng nghĩa với một pipeline nhẹ nhàng hơn nhiều.
Dù tác giả tự nhận đây là "đồ chơi nghiên cứu đơn giản, không phải codec" và chưa được tinh chỉnh, dự án mở ra một hướng đi thú vị: các bài toán nén trong đồ họa vốn đầy rẫy thành phần không khả vi — lượng tử hóa, block compression, đóng gói bit — có thể được giải quyết trọn vẹn bằng tối ưu không đạo hàm. Đây là lời nhắc rằng không phải lúc nào lan truyền ngược cũng là công cụ duy nhất, đặc biệt khi chính cấu trúc bài toán đã chỉ ra cách giảm phương sai hiệu quả.