
Qini có thể chấm điểm sai mô hình uplift: dùng điểm doubly robust
Trên 1 triệu khách hàng mô phỏng, chỉ số Qini đã hiệu chuẩn cho mô hình Linear DR 0,0856, cao hơn 0,0826 của thứ hạng CATE thật. Nguyên nhân là Qini vẫn dùng dữ liệu quan sát nên dính thiên lệch chọn mẫu. Điểm doubly robust (DR) cho kết quả sát mức tăng nhân quả thật hơn.
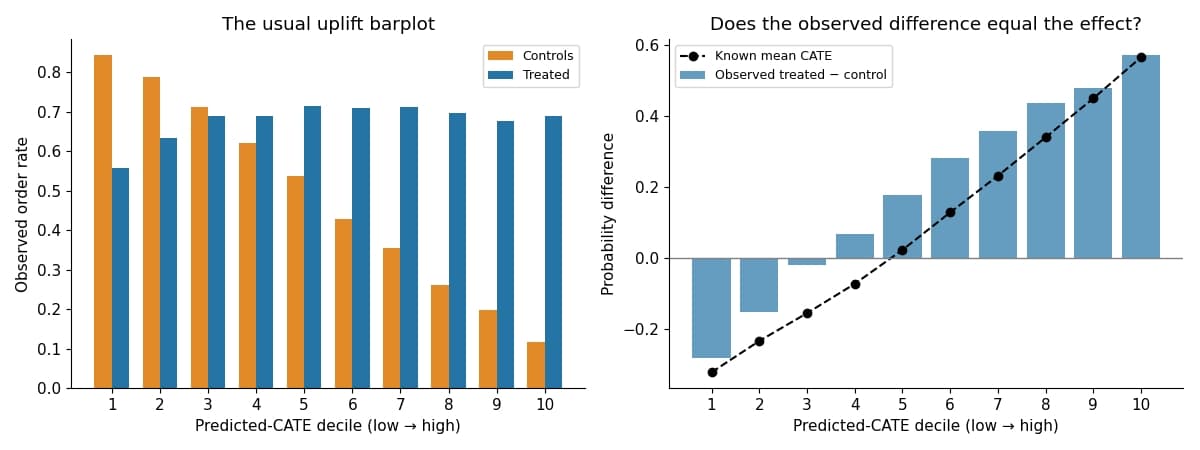
Bài toán đặt ra khá quen thuộc: một công ty cần chọn khách hàng nào để gửi tin nhắn tiếp thị. Thứ hạng tốt nhất phải dựa trên mức tăng xác suất mua hàng khi khách nhận tin nhắn so với khi không nhận. Đó chính là hiệu quả điều trị có điều kiện (CATE), tức chênh lệch kết quả trung bình giữa trường hợp có và không có tác động, với một hồ sơ khách hàng cụ thể.
Công ty không biết các xác suất này nên phải dùng thứ hạng ước lượng. Vấn đề nảy sinh khi chính thước đo dùng để đánh giá các ước lượng đó cũng bị lệch.
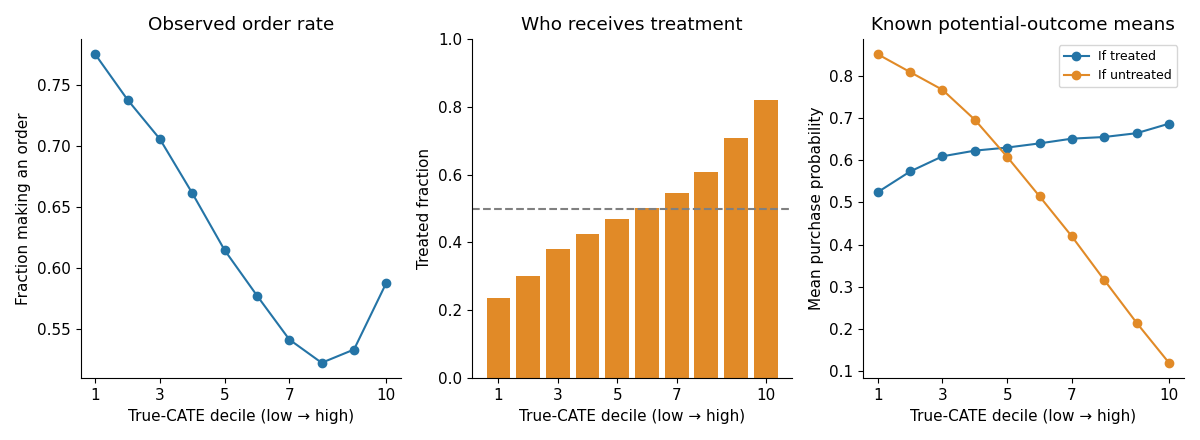 Minh họa đường cong đánh giá mô hình uplift
Khi thước đo chấm điểm sai
Tác giả mô phỏng 1 triệu khách hàng tổng hợp với các đặc điểm: tuổi, thu nhập, chi tiêu trong quá khứ và số ngày kể từ lần liên hệ gần nhất. Chính sách gửi tin phụ thuộc vào tuổi và mức độ tương tác gần đây, với xác suất gửi nằm trong khoảng 0,1 đến 0,9 và trung bình 50% khách được gửi.
Xác suất mua hàng cũng là một hàm logistic phụ thuộc đặc điểm khách. Hiệu quả của tin nhắn không đồng đều giữa các nhóm khách.
Dữ liệu huấn luyện gồm 700.000 khách, đánh giá trên 300.000 khách giữ riêng. Sáu mô hình được thử là S, T, X, DA, DR và DML, mỗi loại chạy với mô hình nền tuyến tính và XGBoost.
Kết quả gây bất ngờ: mô hình Linear DR đạt điểm Qini 0,0856, trong khi thứ hạng dựa trên CATE thật chỉ đạt 0,0826. Xét theo mức tăng nhân quả thật, thứ hạng CATE thật đứng trên với 0,0825 so với 0,0809 của Linear DR.
Vì sao Qini bị lệch
Điểm mấu chốt: Qini vẫn tính trên dữ liệu quan sát, tức là dùng nhãn điều trị và kết quả thực tế. Vì khách được chọn nhận tin dựa trên đặc điểm của họ, chênh lệch giữa nhóm nhận và nhóm không nhận vẫn chứa thiên lệch chọn mẫu (selection bias).
Mô hình nhân quả có thể đã khử nhiễu đúng cách, nhưng thước đo thì chưa. Biểu đồ uplift dạng cột cũng mắc lỗi tương tự: các cột chênh lệch trông hợp lý nhưng không phản ánh hiệu quả thật.
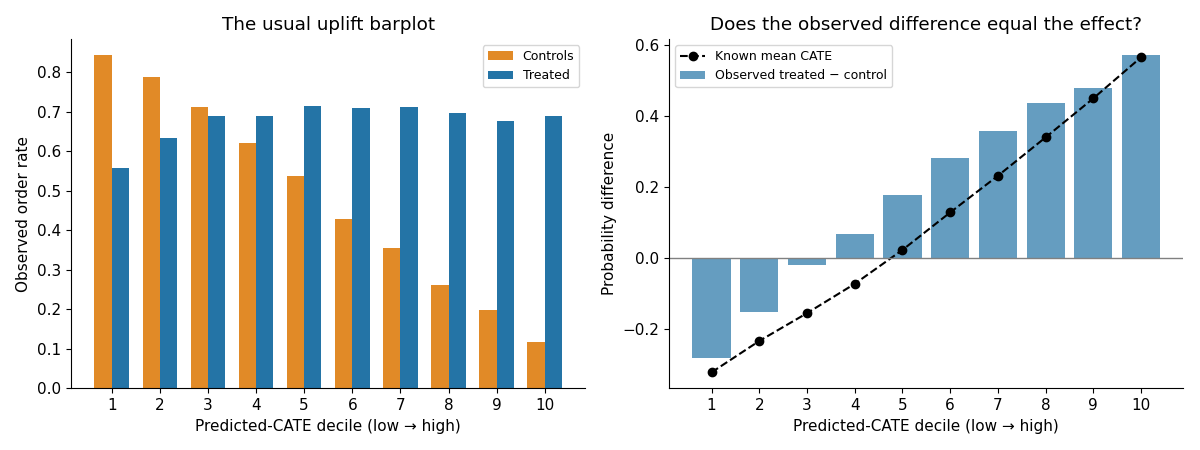 Biểu đồ cột uplift theo thập phân vị
Hệ quả không chỉ là sai số tính toán nhỏ. Nó đổi cả kết luận định tính: chọn mô hình theo Qini có thể dẫn tới thứ hạng kém hơn về lợi ích nhân quả thật.
Cách sửa: IPW và điểm doubly robust
Inverse Propensity Weighting (IPW) gán trọng số cho từng kết quả quan sát theo xác suất khách được gửi tin. Khách có xác suất được gửi thấp nhưng thực tế vẫn được gửi sẽ có trọng số cao, bù lại phần thiếu cân bằng.
Điểm doubly robust (DR) đi xa hơn: dùng thêm mô hình dự đoán kết quả cho cả hai nhánh nhận và không nhận, rồi chỉnh phần dư bằng nghịch đảo xác suất. Nhờ vậy, DR vẫn đúng khi chỉ cần một trong hai điều kiện thỏa mãn: mô hình xác suất đúng, hoặc cặp mô hình kết quả đúng.
Các mô hình nhiễu này được huấn luyện bằng kỹ thuật cross-fitting ba phần, đảm bảo mỗi khách không nằm trong tập huấn luyện khi dự đoán cho chính họ.
Trên dữ liệu mô phỏng, sau khi hiệu chuẩn để cùng mốc so sánh, sai số của Qini trên sáu thứ hạng dao động từ +0,0002 đến +0,0008. IPW và DR chỉ lệch khoảng +0,0001 đến +0,0002. Cả hai đều xếp thứ hạng CATE thật lên trên Linear DR.
Thử nghiệm với 1.000 lần lấy mẫu lặp (bootstrap) trên 300.000 khách giữ riêng cho kết quả nhất quán: mọi khoảng tin cậy 95% của DR cho mức tăng đều nằm dưới 0 khi so với thứ hạng CATE thật. Qini thì ưu ái Linear DR, XGBoost DR và XGBoost DML.
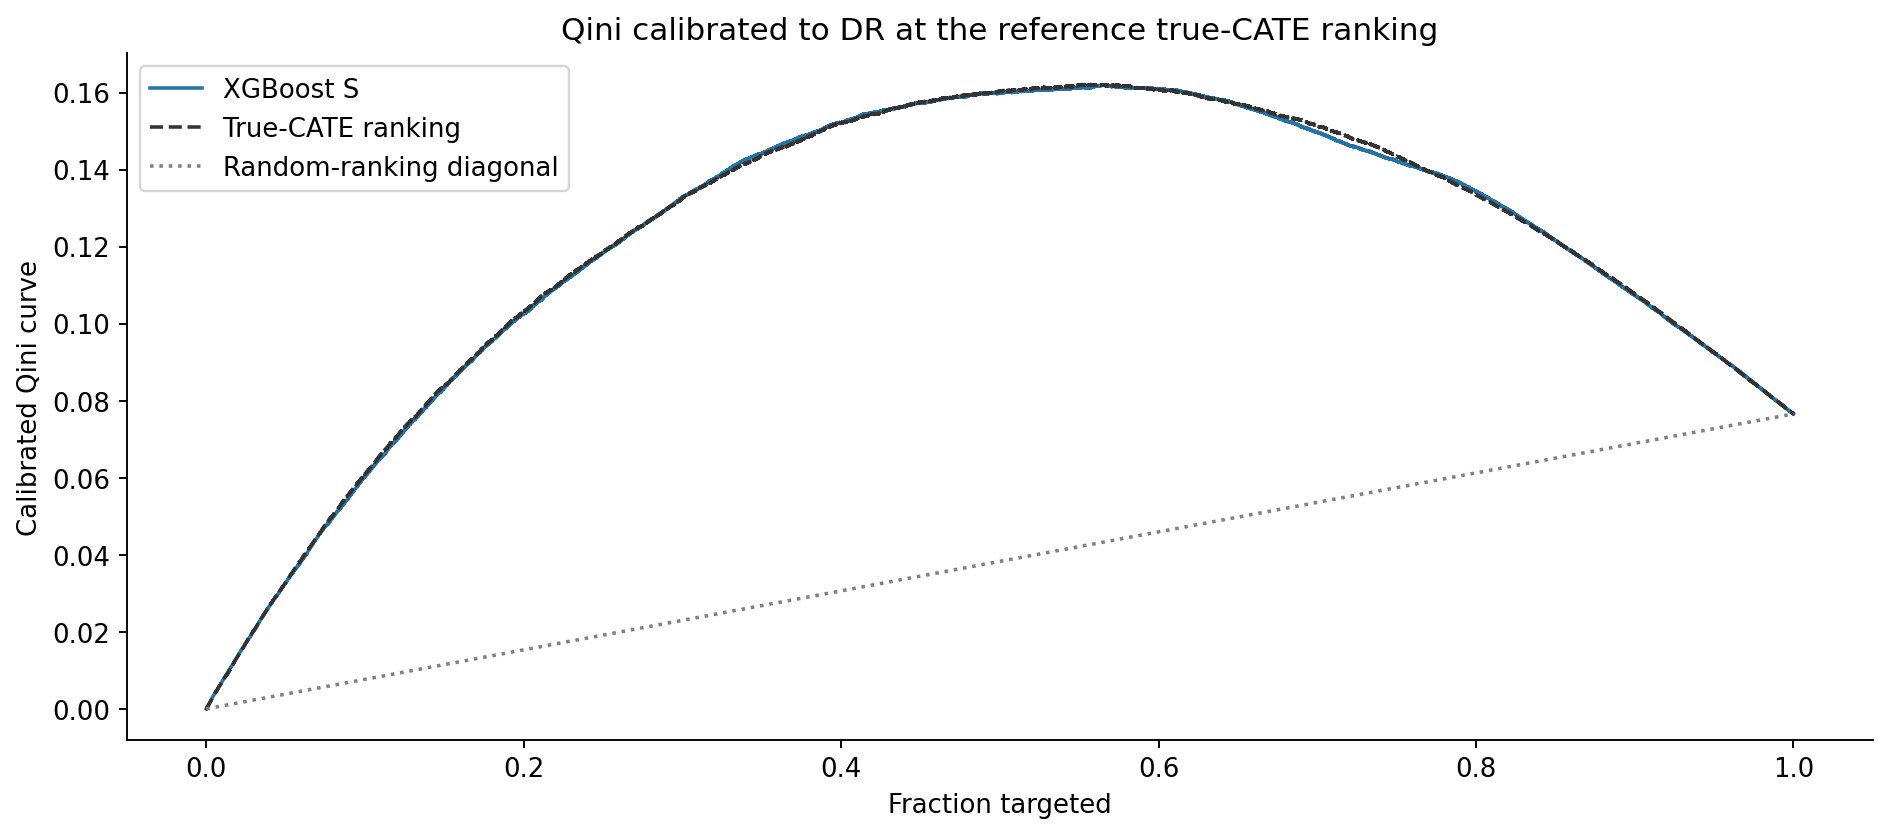 Sai số của từng thước đo so với mức tăng nhân quả thật
Khi đổi chính sách gán can thiệp sang mức chọn lọc thấp và trung bình, IPW và DR gần như không đổi. Qini thì dao động mạnh theo mức độ chọn lọc, thêm một bằng chứng về ảnh hưởng của thiên lệch.
Việc tinh chỉnh siêu tham số (mỗi mô hình thử 15 cấu hình, chọn theo DR gain trên tập kiểm chứng) cũng không làm Qini hết lệch. Với mô hình T, tinh chỉnh giúp DR tăng từ 0,0824 lên 0,0827 và giảm sai số RMSE so với CATE thật từ 0,0328 xuống 0,0237. Với S, kết quả lại xấu đi: DR điểm giảm, RMSE tăng từ 0,0243 lên 0,0316.
Góc nhìn
Với đội ngũ làm sản phẩm và marketing tại Việt Nam, bài học thực tế là đừng tin ngay đường cong Qini khi dữ liệu không đến từ thí nghiệm ngẫu nhiên. Phần lớn dữ liệu vận hành đều có chọn lọc: khách hàng lớn được chăm sóc nhiều hơn, hoặc chỉ một nhóm nào đó được chạy khuyến mãi.
Bước kiểm tra đầu tiên nên là xem cách gán can thiệp có ngẫu nhiên không. Nếu không, hãy tính thêm điểm IPW hoặc DR cho cùng thứ hạng, và đối chiếu hai kết quả trước khi chốt mô hình.
Cũng nên nhớ DR không miễn nhiễm sai số: nó vẫn cần giả định không có nhiễu chưa quan sát và vùng chồng lấn giữa hai nhóm. Nếu chỉ cần chọn nhanh một mô hình khởi điểm, S-learner đơn giản có thể đủ, miễn là thước đo đánh giá đáng tin.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Huấn luyện mô hình chấm điểm trong kỷ nguyên AI: Phương pháp luận lựa chọn mô hình tối ưu
10 tháng 6, 2026
Phần mềm
Ngưỡng Dự Báo Rời Bỏ (Churn) Thực Chất Là Một Quyết Định Về Giá Cả
17 tháng 6, 2026
AI & ML
Xây dựng Mô hình Xếp hạng Tín dụng Bền vững bằng Python: Hướng dẫn Tối ưu hóa Phân tích Tương quan Biến số
04 tháng 4, 2026