
Review code không chỉ là phát hiện lỗi tự động: Góc nhìn bị bỏ quên
Bài viết phản biện lại quan điểm cho rằng các tác nhân AI có thể thay thế hoàn toàn con người trong review code. Tác giả lập luận rằng review code không chỉ là quá trình phát hiện lỗi, mà còn là hoạt động phối hợp, kiến tạo hiểu biết chung và quản trị trách nhiệm — những yếu tố mà máy móc khó có thể đảm nhiệm.
Review code không chỉ là phát hiện lỗi tự động: Góc nhìn bị bỏ quên
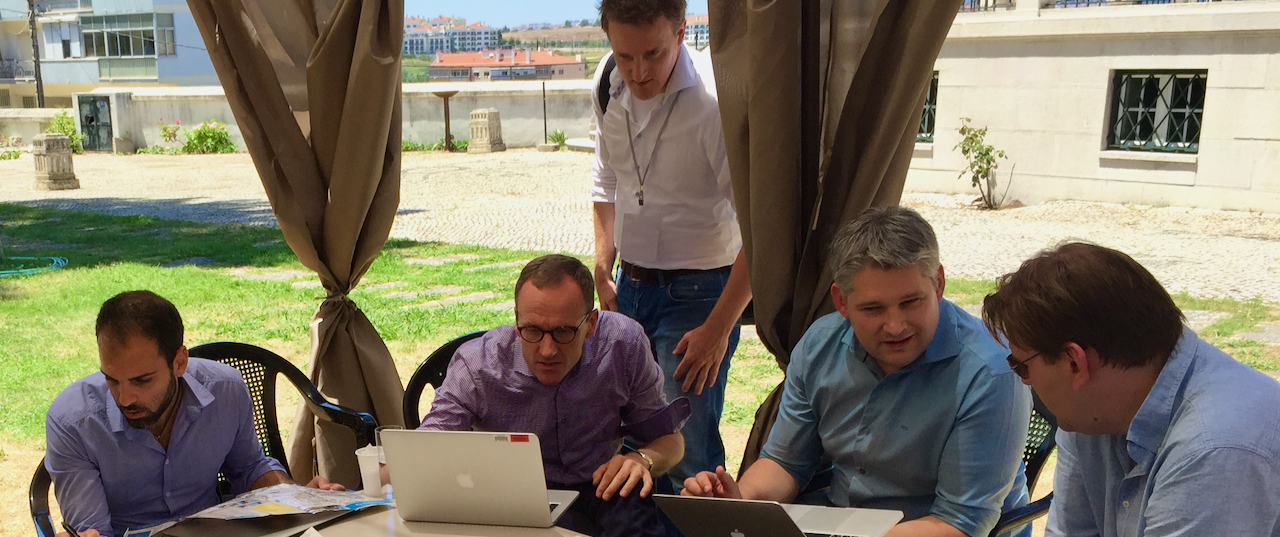
Trong bối cảnh các tác nhân lập trình dựa trên mô hình ngôn ngữ lớn (LLM) ngày càng phổ biến, một bài viết gần đây đặt vấn đề liệu con người có còn cần thiết trong quy trình review code hay không. Tác giả của bài phản biện cho rằng lập luận này dựa trên một ngụy biện thay thế: chia nhỏ công việc của con người thành các chức năng đo lường được, chứng minh máy làm được từng chức năng, rồi tuyên bố con người là dư thừa.
Lập luận gốc: AI đã vượt ngưỡng thay thế con người?
Bài viết "The End of Code Review: Coding Agents Supersede Human Inspection" lập luận rằng các tác nhân lập trình đã đạt đến ngưỡng năng lực khiến review code truyền thống của con người không còn là thành phần thiết yếu trong quy trình đảm bảo chất lượng phần mềm.
Theo đó, mọi mục tiêu của review code đều có thể được các tác nhân đảm nhiệm với chi phí thấp hơn và thông lượng cao hơn. Cách tích hợp ngây thơ — máy viết code, người bắt buộc phải review — được cho là ngõ cụt vì vừa không đảm bảo chất lượng, vừa không mở rộng được theo tốc độ của AI.
Bài viết gốc chia peer review thành bốn chức năng: phát hiện lỗi, áp đặt phong cách, chuyển giao kiến thức và tạo nhận thức chung. Kết luận được đưa ra rất rõ ràng: nếu máy làm được cả bốn, máy có thể thay thế người review.
Vấn đề nằm ở chỗ: lập luận này phụ thuộc vào một cách đóng khung có vấn đề — "ngụy biện thay thế".
Sự bối rối của người review là một phát hiện
Khi một kỹ sư giàu kinh nghiệm đọc một diff và nói "Tôi không hiểu chỗ này", chính sự bối rối đó là một phát hiện. Nó có nghĩa là code quá phức tạp, abstraction sai, hoặc ý định không rõ ràng.
Một LLM luôn "hiểu" code theo nghĩa nó có thể xử lý được đoạn code đó. Nhưng nó không thể đưa ra tín hiệu về sự bối rối chân thực của con người. Khả năng dễ hiểu không chỉ là vấn đề phong cách — nó là thuộc tính nổi lên từ tương tác giữa người cố gắng hiểu và chính đoạn code.
Hoài nghi có cơ sở về sự cần thiết của thay đổi
Những câu hỏi như:
- "Thay đổi này có thực sự nên tách thành hai PR không?"
- "Cách này giải quyết triệu chứng, không phải vấn đề gốc"
...là những câu hỏi về ý định, phạm vi và tính phù hợp. Tất cả đều diễn ra trước khi ai đó xét xem code có "đúng" hay không.
Khung lập luận của bài gốc giả định rằng thay đổi được review là cần thiết, và mục đích chính của review là xác minh. Nhưng bất kỳ ai từng tiếp xúc với môi trường production đều hiểu rằng review code thường là thời điểm cuối cùng — đôi khi là duy nhất — để ai đó chất vấn xem thay đổi có cần thiết hay không.
Khả năng nhìn ra cái không có
Một người review có thể nhận ra rằng hợp đồng API đã thay đổi nhưng xử lý lỗi thì không. Họ có thể nhận ra cái đang thiếu.
Nói cách khác: khả năng nhận diện những gì lẽ ra phải có mặt nhưng lại vắng mặt. Bài gốc hoàn toàn không đề cập đến điều này, dù đây chính là dạng thất bại mà LLM thường rất yếu — hội chứng "mù vắng mặt". Tác nhân AI review những gì đang tồn tại; kỹ sư có chuyên môn dễ dàng nhận ra những gì còn thiếu.
Ai viết code ảnh hưởng đến mức độ soi xét
Người review đồng nghiệp có một kiểu chú ý được hiệu chỉnh từ kinh nghiệm làm việc trước đó với tác giả đoạn code. Ví dụ:
- Commit đầu tiên của một kỹ sư ít kinh nghiệm vào module thanh toán sẽ nhận được mức độ chú ý khác hẳn
- Một refactor thường lệ của một kỹ sư lão luyện sẽ được soi xét theo cách khác
Người review thường khớp bối cảnh "ai, cái gì, khi nào, ở đâu" với kinh nghiệm của chính họ về nơi rủi ro nằm. Bài gốc dường như coi mọi diff là đầu vào tương đương nhau.
Review code là hoạt động hai chiều mang tính kiến tạo
Bài gốc thu gọn chuyển giao kiến thức thành việc truyền đạt thông tin: tác nhân AI đơn thuần "tạo ra giải thích". Nhưng thảo luận trong review code là một hoạt động nhận thức chung.
Người review học về cách tiếp cận của tác giả, tác giả học qua câu hỏi của người review, và kết quả là sự hiểu biết chung mà cả hai bên đều chưa có trước cuộc thảo luận. Đây là công việc đồng kiến tạo, không chỉ là truyền tải thông tin.
Bối cảnh vận hành nằm ngoài repository
Có những thông tin chỉ con người nắm giữ:
- "Dịch vụ này vừa gặp sự cố thứ Ba tuần trước."
- "Nhóm sở hữu consumer downstream đang chuẩn bị deprecate interface đó."
- "Bộ phận pháp lý yêu cầu không log trường này nữa."
Người review sở hữu nhiều kiến thức bối cảnh hơn họ tự nhận thức, dù họ có thể nhận ra các mối liên hệ trong thực tế. Họ hiểu trạng thái hiện tại của tổ chức, các sự kiện gần đây và những thỏa thuận không chính thức không được ghi lại trong test, tài liệu hay hệ thống quản lý phiên bản.
Bài gốc giả định codebase là bối cảnh đầy đủ. Thực tế không bao giờ là như vậy.
Trách nhiệm giải trình không chỉ là thủ tục hành chính
Bài gốc coi trách nhiệm của con người như một yếu tố tuân thủ — một "cá nhân có tên" vì mục đích pháp lý. Nhưng việc ý thức rằng bạn chịu trách nhiệm cá nhân khi phê duyệt một thay đổi định hình cách bạn review nó.
Đó là "skin in the game" — phần da thịt đặt lên bàn cân. Một tác nhân AI "ký duyệt" pull request không gánh chịu hậu quả nào và chắc chắn không có cấu trúc động lực thúc đẩy việc đánh giá nghiêm túc.
Vấn đề cốt lõi: ngụy biện thay thế
Vấn đề nền tảng nhất với bài gốc là nó giả định review code trước hết là một quá trình phát hiện: bạn tìm lỗi, vi phạm phong cách, vấn đề bảo mật — và giả định rằng phát hiện nhanh hơn, rẻ hơn thì luôn tốt hơn.
Nhưng review code còn là:
- Quá trình phối hợp
- Quá trình kiến tạo ý nghĩa
- Quá trình quản trị
Ngụy biện thay thế thường diễn ra theo cùng một kịch bản: chia nhỏ đóng góp của con người thành các chức năng đo lường được, chứng minh máy làm được các chức năng đó, rồi tuyên bố con người dư thừa.
Cách tiếp cận này thường sụp đổ ở cùng một điểm: đóng góp quan trọng nhất của con người là khả năng tích hợp xuyên chức năng — thích ứng với hoàn cảnh và bối cảnh không lường trước, đồng thời đảm nhiệm trách nhiệm xã hội mà tổ chức kỳ vọng.
Những khả năng thích ứng này không được tính đến trong bước chia nhỏ ban đầu. Và theo tác giả bài phản biện, chúng cũng không được tính đến trong bài viết gốc.
Hàm ý cho các nhóm phát triển tại Việt Nam
Với các công ty công nghệ Việt Nam đang tích cực áp dụng AI vào quy trình phát triển, bài học rút ra rất rõ ràng: AI có thể là công cụ hỗ trợ review mạnh mẽ, giúp phát hiện lỗi cú pháp, vi phạm style hay các mẫu bảo mật phổ biến. Nhưng việc thay thế hoàn toàn con người khỏi khâu review có thể khiến đội ngũ mất đi kênh chuyển giao kiến thức quan trọng, khả năng nhận diện rủi ro mang tính tổ chức, và trách nhiệm giải trình thực chất trước các quyết định kỹ thuật.
Cách tiếp cận hợp lý hơn là kết hợp: để AI xử lý các kiểm tra cơ học có thể tự động hóa, đồng thời giữ con người ở vai trò đánh giá các khía cạnh phối hợp, bối cảnh và trách nhiệm — những thứ mà máy móc chưa thể thay thế.
Bạn có thể đọc bài viết gốc tại adaptivecapacitylabs.com và thảo luận trên Hacker News.
Bài viết liên quan

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026
Công nghệ
Muse của Meta: Bước tiến AI đầy tham vọng nhưng vấp phải bài toán niềm tin
27 tháng 9, 2026