Sự bình thường hóa của những thất bại không thể giải thích
Bài viết phân tích xu hướng chấp nhận "đôi khi nó dở tệ" như lời giải thích cuối cùng cho các lỗi phần mềm, đặc biệt trong bối cảnh phát triển bằng AI/LLM. Tác giả lo ngại rằng việc bỏ qua truy vết nguyên nhân gốc rễ sẽ khiến cả người dùng lẫn lập trình viên dần mất đi trách nhiệm giải trình trong kỹ thuật phần mềm.
Khi "đồ dở hơi" trở thành lời giải thích mặc định cho mọi lỗi phần mềm
Có một xu hướng đáng lo ngại đang len lỏi vào ngành công nghệ: chúng ta ngày càng dễ dàng chấp nhận những thất bại không thể giải thích. Trong bối cảnh các mô hình ngôn ngữ lớn (LLM) thúc đẩy tốc độ phát triển phần mềm, câu hỏi về trách nhiệm giải trình và khả năng truy vết nguyên nhân gốc rễ đang trở nên cấp thiết hơn bao giờ hết.
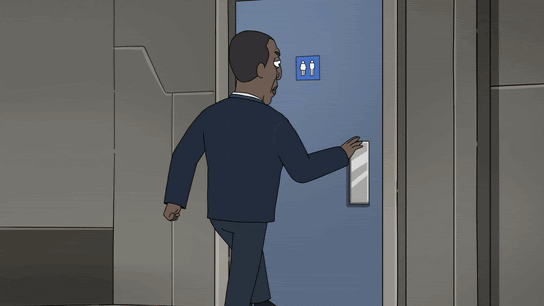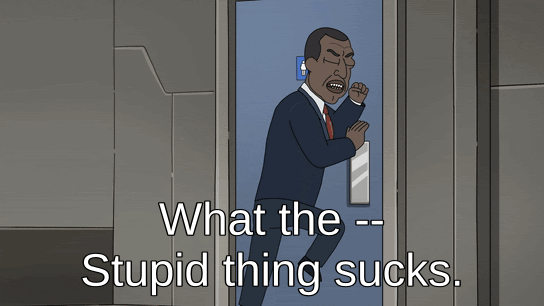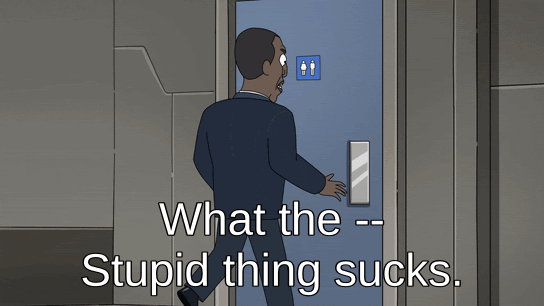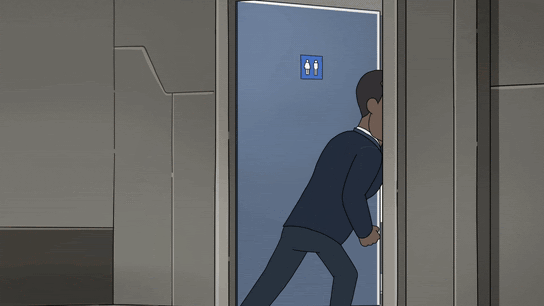 Meme hài hước về những thứ "dở hơi" không chịu hoạt động
Một mô hình tinh thần sai lệch về cửa
Hãy tưởng tượng một nhân vật trong phim hài cố mở một cánh cửa và thất bại hai lần liên tiếp. Cánh cửa không mở vì có vật cản: đầu tiên là một cái xác, sau đó là khoảng một tỷ đô la vàng. Sau mỗi lần thất bại, nhân vật lẩm bẩm: "Đồ dở hơi."
Đây không phải là mô hình tư duy hợp lý về cửa. Cửa không nên "dở hơi" một cách khó hiểu. Luôn có một lý do cụ thể — một vật cản, một hỏng hóc, một điều gì đó có thể nhận diện được. Nhưng trong thế giới phần mềm hiện đại, chúng ta đang dần quen với việc không còn tìm kiếm vật cản đó nữa.
Jev và sự trỗi dậy của "AI mang tính xác suất"
Gần đây, cộng đồng công nghệ xôn xao về Jev, một mô hình AI do TypeSafe AI phát triển, trả về các giá trị kèm theo ước lượng xác suất. Theo như những gì được quảng bá, Jev có bốn đặc điểm chính:
- Nhanh và rẻ
- Có thể tích hợp nhanh chóng
- Nhanh
- Rẻ
Tốc độ và chi phí thấp chắc chắn là những lợi thế. Nhưng sản phẩm này gây khó hiểu ở một điểm cốt lõi: nó không giải quyết phần khó nhất.
Để biết Jev có hoạt động đúng hay không, bạn vẫn phải xây dựng các bài đánh giá (evals) và một pipeline dữ liệu chuẩn (ground-truth). Nếu đã có những thứ đó, bạn gần như đã đi được phần lớn chặng đường để tinh chỉnh giải pháp của riêng mình.
Nói cách khác, Jev hứa hẹn giúp bạn tiết kiệm thời gian, nhưng lại yêu cầu bạn tự làm đúng những việc mà nó được cho là sẽ thay thế.
Vấn đề với điểm tin cậy
Người ủng hộ Jev sẽ lập tức phản biện: "Nhưng Jev cung cấp điểm tin cậy (confidence scores) mà!"
Câu hỏi đặt ra là: bạn sẽ làm gì với những điểm số đó?
Để sử dụng điểm tin cậy một cách hợp lý, bạn cần hai thứ:
- Hiểu về độ hiệu chỉnh (calibration) của các điểm số đó — tức là khi Jev nói 90% tin cậy, nó có thực sự đúng 90% trong trường hợp không?
- Mô hình hóa chi phí của sự không chắc chắn — nếu sai thì thiệt hại bao nhiêu?
Trên thực tế, hầu hết mọi người đều bỏ qua cả hai. Tài liệu của chính Jev đưa ra ngưỡng 0.5 cho "không làm gì" và 0.9 cho "hành động rủi ro cao", kèm theo một ghi chú rằng ngưỡng đúng phụ thuộc vào lĩnh vực và hiệu suất của mô hình. Đây là một cách né tránh trách nhiệm tinh vi.
Kết quả là điểm tin cậy được dùng theo kiểu cargo cult — bắt chước hình thức mà không hiểu bản chất. Tệ hơn, chúng trở thành cái cớ để biện minh cho lỗi: "Mô hình chỉ tự tin 73% thôi mà, nên ngân sách lỗi của tôi là 27%!"
Trách nhiệm giải trình đang biến mất
Khi một nút bấm trên website bị hỏng, chúng ta có một mô hình tinh thần về điều gì đã xảy ra. Có thể DNS bị lỗi. Có thể ai đó đã tung ra mã có lỗi cú pháp JavaScript trên một đường dẫn cụ thể. Có thể một handler ném ra ngoại lệ ngoài dự kiến.
Ngay cả khi bạn chỉ nhận được một mã lỗi HTTP 500 mà không có quyền gỡ lỗi, bạn vẫn kỳ vọng rằng có ai đó có trách nhiệm hiểu tại sao endpoint đó trả về 500. Quyền sở hữu vấn đề dù mờ mịt nhưng vẫn được xác định.
Nhưng với nhiều người dùng, trải nghiệm thực tế chỉ đơn giản là "đồ dở hơi". Phần mềm vốn đã có vẻ thất thường; thêm nhiều lỗi chỉ làm thay đổi tần suất bực bội. Việc loại bỏ khả năng truy vết một thất bại đến nguyên nhân cụ thể dường như không phải là mất mát lớn.
Điều này dẫn đến sự bình thường hóa của tính không thể giải thích.
Nỗi lo thực sự
Nỗi lo không phải là sẽ có nhiều thứ hỏng hơn khi tốc độ phát triển được đẩy nhanh bởi LLM. Điều đó chắc chắn sẽ xảy ra — đó là một phần cái giá của việc xây dựng theo cách mới.
Nỗi lo thực sự là "đôi khi nó chỉ dở hơi thôi" sẽ ngày càng trở thành điểm dừng được chấp nhận của mọi cuộc điều tra.
Điều này đáng buồn vì phát triển tăng tốc bằng LLM thực sự có thể giúp giải quyết những vấn đề này. Có rất nhiều quy trình kiểm thử tự động (QA) chưa được viết ra chỉ vì thiếu thời gian kỹ thuật. Chính bài đánh giá (eval) có thể giúp bạn thay thế — hoặc ít nhất là biện minh cho việc sử dụng — Jev chỉ cách vài câu lệnh.
Bi kịch của kỹ thuật phần mềm ngày nay là chúng ta đang chủ động thiết kế các hệ thống mà cả người dùng lẫn người xây dựng dường như đều không quan tâm đến việc kiểm tra xem có một cái xác nào sau cánh cửa hay không.
Chúng ta chỉ nhún vai và kết luận: đồ dở hơi.
Điều này có ý nghĩa gì với Việt Nam?
Với các đội ngũ phát triển phần mềm tại Việt Nam — nơi tốc độ ra mắt sản phẩm thường được đặt lên hàng đầu — xu hướng này đặc biệt đáng lưu tâm. Việc tích hợp AI vào quy trình phát triển là tất yếu, nhưng nếu đi kèm với việc từ bỏ văn hóa truy vết lỗi và trách nhiệm giải trình, chúng ta có thể đánh đổi chất lượng dài hạn để lấy tốc độ ngắn hạn.
Đầu tư vào các pipeline đánh giá, kiểm thử tự động và văn hóa kỹ thuật coi trọng việc hiểu nguyên nhân gốc rễ không phải là gánh nặng — đó là nền tảng để xây dựng sản phẩm bền vững trong kỷ nguyên AI.