
Vì sao giải mã suy đoán lại nhanh? Bí mật không nằm ở việc giảm khối lượng tính toán
Giải mã suy đoán (speculative decoding) thường được hiểu nhầm là nhanh vì tốn ít phép tính hơn. Thực tế, kỹ thuật này khiến GPU thực hiện nhiều FLOPs hơn cho cùng một chuỗi đầu ra. Điểm mấu chốt là nó chuyển loại công việc của GPU từ nghẽn bộ nhớ (memory bound) sang tận dụng phần tính toán dư thừa, giúp tăng tốc đáng kể khi batch size nhỏ.
Vì sao giải mã suy đoán lại nhanh? Bí mật không nằm ở việc giảm khối lượng tính toán
Có một hiểu lầm phổ biến rằng giải mã suy đoán (speculative decoding) nhanh là vì mỗi token tốn ít phép tính hơn — rằng việc "xác minh" một bản nháp chỉ cần ít FLOPs hơn so với việc sinh ra chính các token đó. Điều này hoàn toàn không đúng.
Sự thật phản trực giác là: kỹ thuật này khiến bạn làm nhiều việc hơn, tổng số phép tính dấu phẩy động (FLOPs) thực thi cho cùng một chuỗi lại tăng lên. Vậy tại sao nó vẫn nhanh? Câu trả lời nằm ở loại công việc mà GPU đang đảm nhận.
Ôn nhanh về giải mã suy đoán
Giải mã suy đoán là kỹ thuật dùng một mô hình nháp (draft model) nhỏ để đề xuất một chuỗi token khả dĩ, sau đó dùng mô hình lớn để xác minh chuỗi đó song song trong một lần lan truyền tiến (forward pass).
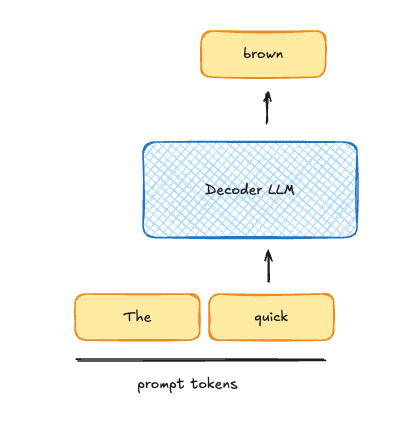
Cách giải mã LLM truyền thống đi từng token một:
 Giải mã tuần tự từng token một
Trong khi giải mã suy đoán cho phép nhìn nhiều token cùng lúc và chấp nhận những token mà mô hình lớn lẽ ra sẽ sinh ra:
 Giải mã suy đoán xác minh nhiều token song song
Hai loại công việc của GPU
Khi một mô hình chạy trên GPU, có nhiều loại công việc diễn ra. Loại dễ thấy là các phép nhân ma trận, tích vô hướng và các phép toán tensor. Nhưng một loại quan trọng và ít hiển nhiên hơn là: nạp dữ liệu từ bộ nhớ toàn cục vào bộ nhớ cục bộ (và ngược lại).
- Khi GPU phải chờ dữ liệu được nạp cho một phép toán, ta gọi đó là nghẽn bộ nhớ (memory bound).
- Khi mọi thứ đã được nạp nhưng phải chờ các phép toán tensor hoàn tất, ta gọi đó là nghẽn tính toán (compute bound).
Khi LLM giải mã từng token một, nó rất nghẽn bộ nhớ. Với mỗi token, ta phải truyền toàn bộ các tham số đang hoạt động của mô hình — ví dụ 27 tỷ tham số với Qwen3.5-27B. Khi LLM giải mã theo lô (batched decode) hàng nghìn token trong một bước, nó lại nghẽn tính toán.
 Giải mã theo lô đẩy GPU sang trạng thái nghẽn tính toán
Điểm mấu chốt: khi giải mã bị nghẽn bộ nhớ, bạn đang lãng phí năng lực tính toán. GPU hoàn toàn có thể làm thêm phép toán nhưng lại không làm. Chẳng hạn, nếu giải mã 2 chuỗi thay vì 1, thời gian mỗi token sẽ không tăng lên. Giải mã suy đoán chính là cách tận dụng phần tính toán dư thừa đó để tăng tốc (ở batch size nhỏ).
Đánh đổi chiều rộng lấy chiều sâu
Để cụ thể hóa, giả sử số token tối ưu để chạy trong một lần lan truyền tiến là 5. Chạy ít hơn thì nghẽn bộ nhớ, nhiều hơn thì nghẽn tính toán. Ta có hai lựa chọn.
Cách một — tăng chiều rộng: chạy batch size 5 chuỗi, mỗi chuỗi giải mã từng token một. Cả 5 chuỗi đều tiến được một chút.
 Chiều rộng: nhiều chuỗi cùng tiến một bước nhỏ
Cách hai — tăng chiều sâu: dùng giải mã suy đoán để chạy 5 token trong một chuỗi duy nhất, đạt độ sâu lớn cho chuỗi đó. Một chuỗi tiến được rất xa.
 Chiều sâu: một chuỗi tiến nhiều bước cùng lúc
Trong cả hai trường hợp, GPU làm khối lượng công việc xấp xỉ như nhau. Nếu thêm chuỗi và vẫn suy đoán ở cùng độ sâu, bạn chỉ khiến tất cả chậm lại vì đã rơi vào trạng thái nghẽn tính toán. Nhưng ở batch size nhỏ (khi batch size nhỏ hơn nhiều so với số token tối ưu), giải mã suy đoán cho phép dùng phần tính toán "miễn phí" để hoàn thành các chuỗi nhanh hơn.
Vì sao điều này quan trọng?
Nghe có vẻ hàn lâm, nhưng đây là vấn đề thực tế khi vận hành hệ thống phục vụ người dùng hoặc khi nghiên cứu sâu về giải mã suy đoán.
Nếu số batch tối ưu là 5 mà ta vẫn bật giải mã suy đoán, ta đang lãng phí tính toán trong khi lẽ ra có thể dùng thời gian đó để nạp bộ nhớ. Đặc biệt khi tỷ lệ chấp nhận không đạt 100%, mỗi token bị từ chối là một phần công việc thừa bị đổ đi.
Đó là lý do vLLM cung cấp tùy chọn tắt hoàn toàn giải mã suy đoán ở lưu lượng cao thông qua tham số --speculative-disable-by-batch-size. Và cũng từ đây, các nhà nghiên cứu đặt câu hỏi: tại sao lúc nào cũng phải suy đoán ở cùng một độ sâu? Tại sao không suy đoán sâu khi còn dư tính toán (batch size nhỏ), và suy đoán nông — hoặc thậm chí động theo từng chuỗi — khi batch size lớn hơn?
Đây chính là trực giác cốt lõi đằng sau những ý tưởng như dSpark.
Với người dùng và đội ngũ vận hành AI tại Việt Nam, bài học thực tiễn khá rõ: giải mã suy đoán không phải "phép màu" giúp mọi cấu hình đều nhanh. Nó chỉ phát huy tác dụng trong vùng batch size nhỏ — như các ứng dụng chatbot cá nhân, trợ lý nội bộ hay môi trường thử nghiệm ít người dùng. Còn ở hệ thống phục vụ hàng loạt, việc cấu hình đúng tham số và biết khi nào nên tắt mới là yếu tố quyết định hiệu năng thực tế.

