
Xây dựng pipeline RAG cho tìm kiếm ngữ nghĩa trong mã nguồn: Ghi chép từ JetBrains
JetBrains chia sẻ chi tiết cách họ xây dựng Air Context – một hệ thống RAG giúp các agent lập trình tìm kiếm mã nguồn theo ngữ nghĩa thay vì chỉ dò từ khóa. Bài viết tập trung vào giai đoạn đầu của pipeline: phân tích cú pháp, chia nhỏ mã nguồn thành các đoạn hợp lý, vector hóa và tối ưu lưu trữ bằng lượng tử hóa nhị phân.
Xây dựng pipeline RAG cho tìm kiếm ngữ nghĩa trong mã nguồn: Ghi chép từ JetBrains
Trong kỷ nguyên lập trình do agent dẫn dắt, việc tìm đúng đoạn mã liên quan trở thành yếu tố then chốt quyết định hiệu suất và chất lượng sản phẩm. JetBrains mới đây đã công bố loạt bài chia sẻ về hành trình xây dựng Air Context – hệ thống tìm kiếm mã nguồn theo ngữ nghĩa dựa trên RAG (retrieval-augmented generation). Bài viết dưới đây tóm lược phần đầu tiên, tập trung vào ba giai đoạn nền tảng: phân tích cú pháp, chia nhỏ (chunking) và vector hóa.
Vì sao tìm kiếm ngữ nghĩa lại quan trọng?
Agent lập trình thường dùng các công cụ truyền thống như tìm kiếm từ khóa hay grep. Những công cụ này có một hạn chế cố hữu: chúng buộc agent phải biết trước chính xác chuỗi ký tự cần tìm.
Khi agent muốn biết session token được làm mới ở đâu, nó không thể trông chờ vào việc mã nguồn tình cờ chứa chữ "refresh".
Để lý luận trong những miền trừu tượng, agent cần khả năng tìm kiếm mã nguồn theo ý nghĩa – tức tìm kiếm ngữ nghĩa. Đây chính là lúc RAG phát huy tác dụng: nếu có thể đánh chỉ mục mã nguồn theo cách nắm bắt ngữ nghĩa, rồi cho agent truy xuất các đoạn liên quan bằng truy vấn văn bản tự do, ta tạo ra một giao diện đúng với thế mạnh của agent.
 JetBrains AI
Từ bản thử nghiệm đến sản phẩm thực tế
Một bản prototype RAG thuần túy rất đơn giản để dựng. Nhưng một giải pháp đủ chuẩn production lại là câu chuyện hoàn toàn khác. JetBrains thừa nhận họ đã đi không ít đường vòng trước khi hoàn thiện Air Context, và loạt bài này nhằm chia sẻ những gì họ ước được ai đó nói cho biết ngay từ ngày đầu.
Phân tích cú pháp và chia nhỏ: cây AST tinh tế
Đây là bước tiền xử lý quan trọng nhưng thường bị xem nhẹ. Với các dự án quy mô lớn, mỗi file mã nguồn có thể chứa hàng trăm đến hàng nghìn dòng, gồm nhiều lớp, trường và phương thức với mức độ liên quan khác nhau.
Bài toán kích thước chunk:
- Quá lớn: Nếu nhét cả file vào một embedding duy nhất, tìm kiếm sẽ trả về nguyên cả file – vô nghĩa với mục tiêu tìm một hàm hay ký hiệu cụ thể.
- Quá nhỏ: Nếu embedding từng dòng riêng lẻ, các dòng có thể mất ngữ cảnh và mang nghĩa ngữ nghĩa không đáng kể, khiến kết quả truy xuất sai.
Giải pháp nằm ở việc chia nhỏ theo cấu trúc. Mỗi file mã nguồn đều có cấu trúc tương đối rõ ràng – ví dụ với Java, phần import nằm trên đầu, tiếp đến là định nghĩa lớp, rồi các trường và phương thức. Hiểu được quy ước này cho phép chia chunk thông minh hơn nhiều so với việc cắt theo số dòng cố định.
Chia nhỏ dựa trên cấu trúc
JetBrains đã phát triển các parser đủ thông minh để xử lý những đặc thù của từng ngôn ngữ trong suốt 26 năm qua. Chúng tạo nên nền tảng JetBrains Code Engine, trên đó Air Context được xây dựng. Hiện tại, Air Context hỗ trợ phân tích và chia nhỏ theo cấu trúc cho chín ngôn ngữ chính: Kotlin, Java, Python, JavaScript, TypeScript, C#, PHP, Go và Rust. Với các ngôn ngữ khác, hệ thống chuyển sang chia theo dòng để đảm bảo mọi ngôn ngữ đều có thể được đánh chỉ mục.
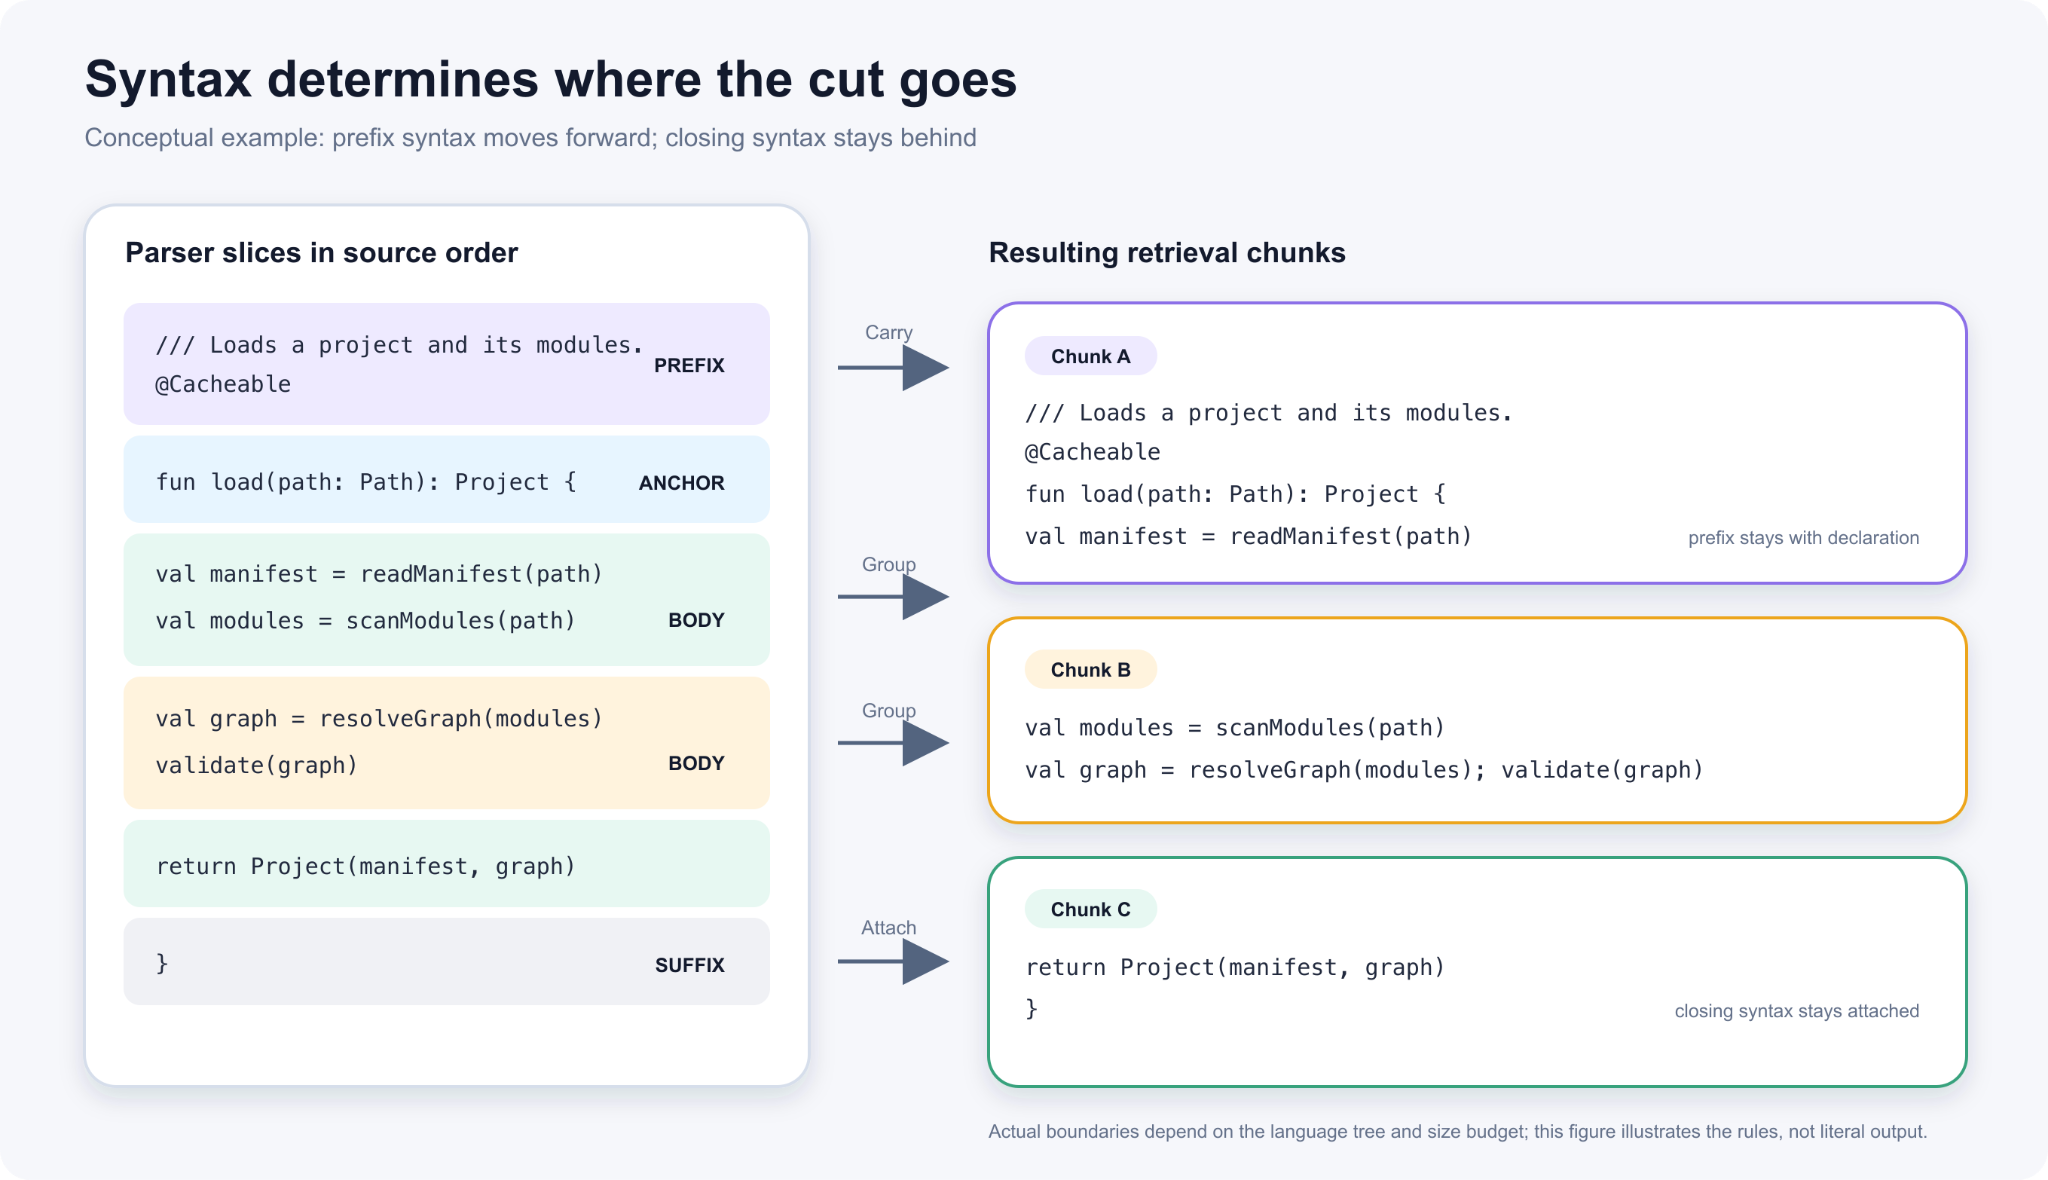
Thuật toán giữ lại các đơn vị cú pháp lớn nhất vừa với ngưỡng, chỉ chia nhỏ những đơn vị quá lớn và gom các đơn vị nhỏ liền kề để tránh những chunk nhỏ vô nghĩa. Cách tiếp cận này có nhiều điểm tương đồng với phương pháp cAST công bố năm 2025, nhưng JetBrains mã hóa nhiều ngữ nghĩa ngôn ngữ hơn vào triển khai của mình – chẳng hạn giữ decorator của Python đi cùng định nghĩa, hay KDoc nằm cạnh khai báo Kotlin.
Sau khi gom nhóm, chunk được chuẩn hóa: cắt khoảng trắng thừa, xóa dòng trống và loại bỏ thụt lề chung nhưng vẫn bảo toàn thụt lề tương đối. Cuối cùng, chunk được đính kèm metadata đường dẫn tương đối trước khi chuyển sang bước embedding.
Việc đánh giá chất lượng chunk được thực hiện bằng chiến lược LLM-as-a-judge: một mô hình đóng vai trò giám khảo kiểm tra xem ranh giới chunk có hợp lý không, có xuất hiện các hiện tượng bất thường như tài liệu bị tách rời hay cú pháp đóng mồ côi hay không.
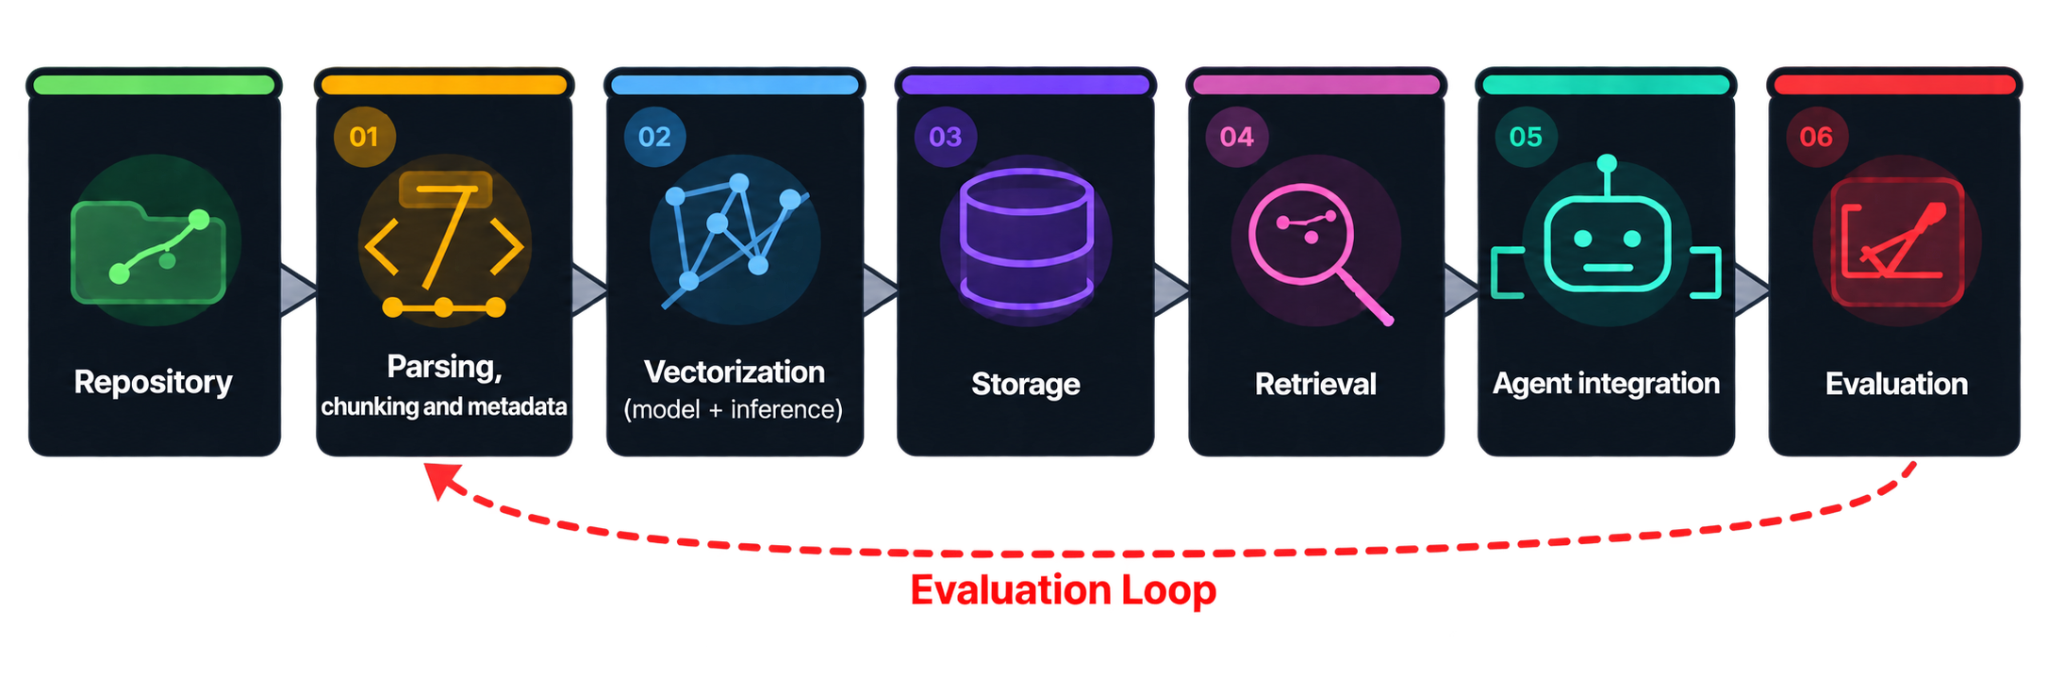 Sơ đồ pipeline
Vector hóa: biến mã nguồn thành con số
Vector hóa là quá trình một mô hình embedding đọc đoạn văn bản và xuất ra một danh sách số có độ dài cố định (vector), tương ứng với một điểm trong không gian vài nghìn chiều. Điểm mấu chốt: mô hình được huấn luyện sao cho các văn bản có ý nghĩa tương tự sẽ nằm gần nhau.
Nhờ đó, một hàm "xả các thao tác ghi được đệm" và một hàm "rút cạn hàng đợi đang chờ" có thể nằm gần nhau dù không chia sẻ từ khóa nào – điều mà tìm kiếm truyền thống bỏ lỡ.
Bài toán chi phí lưu trữ
Một embedding đơn lẻ thì rẻ, nhưng một kho mã nguồn lớn sinh ra hàng triệu chunk, đồng nghĩa hàng triệu vector phải lưu trữ, nạp vào bộ nhớ và so sánh với mỗi truy vấn. Một vector vài nghìn chiều ở định dạng số thực 32-bit nặng khoảng 16 KB, nên vài triệu chunk có thể ngốn hàng chục gigabyte chỉ riêng chỉ mục.
Câu hỏi trọng tâm chuyển từ "chính xác đến đâu?" sang "mỗi byte đổi lại được gì?". Có hai hướng giảm chi phí:
- Giữ ít chiều hơn: cắt ngắn vector rồi chuẩn hóa lại.
- Giữ nguyên số chiều nhưng giảm độ chính xác số học: dùng ít byte hơn cho mỗi chiều.
Hai hướng này độc lập và có thể kết hợp. Nhưng thử nghiệm cho thấy sự đánh đổi không hề cân bằng: với ngân sách 512 byte mỗi vector, việc giữ đủ 4.096 chiều ở mức 1 bit mỗi chiều truy xuất tốt hơn hẳn so với giữ 128 chiều ở độ chính xác 32-bit đầy đủ.
Vì sao số chiều quan trọng hơn độ chính xác?
Hãy hình dung mỗi chiều như một câu hỏi nhỏ mà mô hình đã học để đặt ra về đoạn văn bản: Đây có phải về xử lý lỗi không? Nó có chạm đến mạng không? Đây có phải mã kiểm thử không?
Hai chunk được coi là tương tự khi câu trả lời của chúng khớp nhau ở nhiều câu hỏi. Vì vậy, ta nên đánh giá vector dựa trên độ phủ câu hỏi hơn là độ chính xác của câu trả lời.
Một bảng hỏi dài được điền bằng dấu tích tốt hơn một bảng hỏi ngắn được điền chính xác đến sáu chữ số thập phân.
Giữ đủ 4.096 chiều ở 1 bit bảo toàn câu trả lời có/không thô cho mọi câu hỏi. Cắt xuống 128 chiều giữ câu trả lời rất chính xác cho 3% câu hỏi và vứt bỏ phần còn lại – và không lượng chính xác nào trên các chiều còn sót lại có thể khôi phục thông tin đã mất.
Lượng tử hóa nhị phân và khoảng cách Hamming
JetBrains chọn giữ toàn bộ số chiều và đẩy giảm độ chính xác đến giới hạn: mỗi vector chỉ còn 1 bit, nhỏ hơn 32 lần so với số thực 32-bit. Quá trình lượng tử hóa bất ngờ lại rất đơn giản – mọi thành phần từ 0 trở lên thành 1, mọi thành phần âm thành 0.
Việc đổi cách biểu diễn cũng kéo theo đổi thước đo. Độ tương đồng cosine cần đến độ lớn đã bị vứt bỏ, nên vector nhị phân được so sánh bằng khoảng cách Hamming – đơn giản là số vị trí mà hai mẫu bit khác nhau. Phép tính này nhanh đến mức đáng kinh ngạc: một vector 4.096 bit lưu dưới dạng 64 word 64-bit, so sánh hai vector chỉ cần XOR từng cặp word rồi đếm số bit 1 – tốn khoảng trăm lệnh CPU, trong khi cosine similarity trên số thực gốc cần hàng nghìn phép nhân.
Giới hạn của lượng tử hóa nhị phân
Tuy nhiên, đánh đổi này có một cái giá tinh tế hơn. Lượng tử hóa nhị phân không chỉ hy sinh độ chính xác mà còn nén dải điểm tương đồng. Với vector độ chính xác đầy đủ, một cặp không liên quan có thể đạt điểm gần 0 còn cặp gần trùng đạt gần 1. Với bit dấu, khoảng một nửa số bit của hai vector hoàn toàn không liên quan vẫn trùng nhau do ngẫu nhiên, còn cặp liên quan mạnh có thể chỉ đạt hai phần ba.
Hệ quả: mọi điểm số trong chỉ mục đều rơi vào dải hẹp đó. Việc xếp hạng vẫn sống sót, nhưng việc đặt ngưỡng thì không. Bất kỳ ngưỡng cắt nào đặt trong dải hẹp ấy đều hoặc kích hoạt tất cả, hoặc không kích hoạt gì cả.
Vì vậy, ở những nơi cần đánh giá mức độ liên quan tuyệt đối thay vì thứ tự tương đối, JetBrains vẫn giữ số thực 16-bit và chấp nhận chi phí lưu trữ cao hơn.
 Minh họa vector và khoảng cách
Phạm vi embedding và bài toán đường dẫn
Đánh chỉ mục và tìm kiếm dùng cùng một mô hình nhưng phục vụ hai mục đích rất khác nhau. Đánh chỉ mục bị giới hạn bởi thông lượng, xử lý hàng triệu chunk bất đồng bộ, GPU bão hòa sau khoảng 32 chunk mỗi lô. Tìm kiếm thì cần nhanh và phản hồi tức thì – người dùng sẽ bỏ đi nếu không có kết quả trong vòng vài giây.
JetBrains chọn mô hình instruction-following với sự bất đối xứng có chủ đích giữa hai phía: truy vấn là câu hỏi ngắn bằng ngôn ngữ tự nhiên, còn tài liệu là một đoạn mã. Mỗi chunk được embedding kèm đường dẫn file để bổ sung metadata mà chunk đơn lẻ thiếu: nó nằm ở module nào, file là gì.
Nhưng trong các monorepo, bản thân đường dẫn lại thành vấn đề. Monorepo của IntelliJ IDEA có hơn một triệu file; file nguồn trung vị nằm sâu chín thư mục sau đường dẫn dài 91 ký tự, và gần 10.000 file có đường dẫn dài hơn 150 ký tự. Trong khi đó, file ở cuối đường dẫn dài nhất chỉ vỏn vẹn 24 dòng.
Giải pháp: đường dẫn được giới hạn độ dài trước khi đưa vào mô hình, với nguyên tắc cả hai đầu đều sống sót. Các phân đoạn đầu cho biết module, hai phân đoạn cuối (thư mục cha trực tiếp và tên file) cho biết file là gì. Phần giữa bị lược bỏ thành … khi cần. Khi người dùng giới hạn phạm vi tìm kiếm vào một thư mục con, phạm vi đó cũng được đưa thẳng vào văn bản truy vấn theo cùng định dạng rút gọn, giúp vector truy vấn rơi đúng vùng của các chunk cần khớp.
Bảo vệ mã nguồn
Mã nguồn của một doanh nghiệp thường là cốt lõi tài sản trí tuệ. Đưa nó lên các mô hình đám mây bên thứ ba làm tăng nguy cơ rò rỉ dữ liệu nhạy cảm. Vì vậy, JetBrains áp dụng hai nguyên tắc ngay từ đầu:
- Không lưu trữ mã trong hệ thống của họ: một chunk chỉ chứa tham chiếu cụm, loại mục, đường dẫn file, offset bắt đầu và kết thúc, tham chiếu vector và metadata tùy chọn. Không có nội dung, không có bản sao mã nguồn nào được lưu. Tìm kiếm trả về tọa độ, còn đoạn mã bạn thấy được lắp ráp ngay trên máy bạn từ bản checkout của bạn.
- Không dùng dữ liệu để huấn luyện: mọi chỉ mục mã mà Air Context xây dựng đều được embedding bằng mô hình trọng số mở, chạy trên GPU do JetBrains vận hành. Không có yêu cầu embedding nào rời khỏi hạ tầng của họ.
Đáng chú ý, những ràng buộc tự đặt này không khiến chất lượng truy xuất giảm sút. JetBrains đã đánh giá các mô hình trọng số mở với API embedding của các nhà cung cấp lớn trên bộ benchmark riêng, và lựa chọn của họ đứng đầu.
Tổng kết
Bài viết đầu tiên trong loạt này đã đi qua chặng đầu của pipeline: từ file mã nguồn thô đến các vector nhị phân gọn nhẹ sẵn sàng cho tìm kiếm. Những vấn đề còn lại – lưu trữ hàng triệu vector hiệu quả, xây dựng hệ thống trả lời truy vấn trong mili giây, đánh giá liên tục kết quả, và tích hợp RAG vào agent – sẽ được trình bày trong các phần tiếp theo.
Air Context hiện đang ở giai đoạn public preview và đã có sẵn trong giấy phép JetBrains. Với các nhà phát triển Việt Nam đang làm việc trên những codebase lớn, đây là một hướng tiếp cận đáng tham khảo khi bài toán tìm kiếm mã nguồn theo ngữ nghĩa ngày càng trở nên cấp thiết trong quy trình phát triển phần mềm hiện đại.
Bài viết liên quan

Công nghệ
Mô hình AI hàng đầu giỏi Vật lý đến đâu? Nghiên cứu mới chỉ ra các bài kiểm tra hiện hành đang đánh giá sai
16 tháng 9, 2026

Công nghệ
Nộp đơn xin việc lẽ ra nên khó hơn. Thật đấy
25 tháng 8, 2026
Công nghệ
CISA cảnh báo về thiết bị OT phơi nhiễm Internet: Có cách phòng thủ nhẹ hơn không?
04 tháng 10, 2026