
Conformal Prediction: Bước tiến giúp mô hình học máy từ "chính xác" trở nên "đáng tin cậy"
Độ chính xác tổng thể chưa đủ để thuyết phục các bên liên quan về một mô hình học máy. Conformal Prediction bổ sung khoảng dự đoán cho từng kết quả, định lượng mức độ bất định để mỗi dự đoán có thể được đánh giá độ tin cậy. Bài viết phân tích cách phương pháp này hoạt động và minh họa bằng ví dụ về dự đoán ý định mua hàng của khách trực tuyến.
Conformal Prediction: Bước tiến giúp mô hình học máy từ "chính xác" trở nên "đáng tin cậy"
Khi xây dựng mô hình học máy, các chỉ số tổng hợp như độ chính xác, recall hay AUROC thường không đủ để thuyết phục các bên liên quan về hiệu năng thực tế. Conformal Prediction (CP) giải quyết khoảng trống này bằng cách tạo ra một khoảng dự đoán quanh mỗi kết quả, giúp định lượng mức độ bất định và biến các con số kỹ thuật thành thông tin có thể hành động.
Vì sao chỉ số tổng hợp là chưa đủ?
Trong thực tế triển khai mô hình, câu hỏi mà doanh nghiệp quan tâm không phải là "mô hình chính xác bao nhiêu phần trăm trên tập test" mà là "tôi có thể tin tưởng vào từng dự đoán cụ thể đến mức nào". Một dự đoán xác suất mua hàng 77% nghe có vẻ hấp dẫn, nhưng nếu khoảng biến thiên thực tế dao động từ 50% đến 97% thì giá trị đó gần như không dùng được để ra quyết định. Ngược lại, nếu dự đoán 77% đi kèm khoảng 70% – 85% thì độ tin cậy cao hơn hẳn.
Đây chính là điểm khác biệt cốt lõi giữa độ chính xác (accuracy) và độ tin cậy (reliability) — hai khái niệm mà nhiều tổ chức vẫn nhầm lẫn khi đánh giá mô hình AI.
 Minh họa khoảng dự đoán và mức độ bất định trong học máy
Conformal Prediction hoạt động như thế nào?
CP là một quy trình thống kê bao quanh mô hình dự đoán có sẵn, tạo ra khoảng dự đoán cho từng giá trị đầu ra. Phương pháp này có ba ưu điểm nổi bật so với các kỹ thuật định lượng bất định khác như bootstrap hay dropout:
- Không phụ thuộc vào kiến trúc mô hình: hoạt động tốt với mô hình hộp đen, từ hồi quy, boosting/bagging đến mạng nơ-ron.
- Chi phí tính toán thấp, đặc biệt so với bootstrap — vốn phải lấy mẫu lặp lại nhiều lần.
- Đảm bảo tính hoán đổi (exchangeability): nhờ đó, khoảng dự đoán tính trên tập hiệu chuẩn vẫn giữ được mức bao phủ hợp lệ trên tập kiểm thử. Nếu tỷ lệ α điểm hiệu chuẩn nằm ngoài khoảng, thì trung bình tỷ lệ tương tự cũng đúng trên dữ liệu mới.
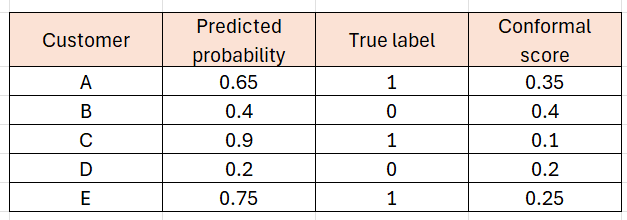
Quy trình chuẩn gồm bốn bước: chia dữ liệu thành tập huấn luyện – tập hiệu chuẩn – tập kiểm thử (thường theo tỷ lệ 70/15/15), huấn luyện mô hình, tính điểm conformal (ví dụ độ lệch tuyệt đối giữa xác suất dự đoán và nhãn thực), rồi lấy phân vị 1−α của điểm đó làm lượng tử conformal (q).
Minh họa với dữ liệu dự đoán ý định mua hàng
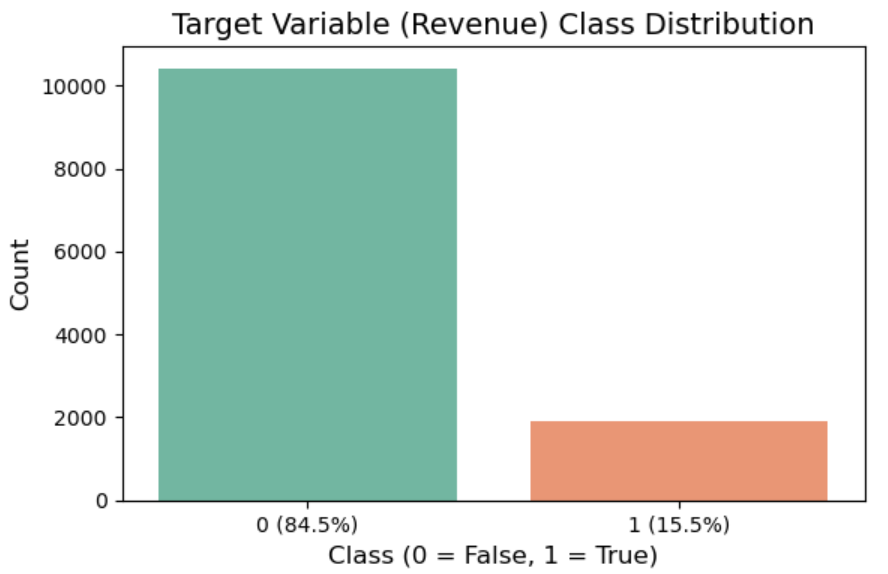
Bài viết gốc sử dụng bộ dữ liệu Online Shoppers Purchasing Intention của UCI (giấy phép CC BY 4.0) — một ví dụ điển hình cho bài toán dự đoán hành vi khách hàng thương mại điện tử. Với mô hình XGBoost có xử lý mất cân bằng lớp (chỉ khoảng 15% phiên truy cập dẫn đến mua hàng), tác giả thực hiện hai cách tiếp cận:
Cách 1 – Khoảng cố định: dùng chung lượng tử q cho mọi điểm dự đoán. Cách này đơn giản nhưng gần như tạo ra cùng một độ rộng khoảng cho tất cả khách hàng, chưa phản ánh được sự khác biệt về độ tin cậy giữa các dự đoán.
Cách 2 – Khoảng thích ứng cục bộ: tính trọng số Gaussian dựa trên khoảng cách Euclid giữa điểm kiểm thử và từng điểm hiệu chuẩn, rồi tính phân vị có trọng số. Kết quả là mỗi dự đoán có độ rộng khoảng riêng, phản ánh mức tương đồng với dữ liệu hiệu chuẩn. Đánh đổi là phương pháp này không còn giữ được bảo đảm bao phủ hình thức như cách cố định.
 Minh họa phân vị conformal và khoảng dự đoán thích ứng
Lọc ra những dự đoán đáng tin cậy nhất
Một phát hiện thú vị: độ rộng khoảng dự đoán tăng dần đến mức xác suất 50% rồi giảm về hai cực. Điều này hợp lý — các trường hợp rõ ràng (gần như chắc chắn mua hoặc không mua) có khoảng hẹp, còn vùng "lưỡng lự" có khoảng rộng và kém tin cậy hơn.
Với ngưỡng xác suất mua hàng 70%, mô hình dự đoán 305/1850 khách (16,5%) là "có khả năng mua". Nhưng để chỉ giữ lại những dự đoán thực sự đáng tin, có thể áp dụng một trong ba tiêu chí:
- Tùy chọn A: biên dưới và biên trên đều nằm trong khoảng ±30% quanh giá trị dự đoán.
- Tùy chọn B: độ rộng khoảng ≤ 30% — trong ví dụ chỉ còn 129/305 khách (37,4%) đạt chuẩn.
- Tùy chọn C: độ rộng khoảng ≤ 30% của chính xác suất dự đoán — còn 103/305 khách (29,9%).
Sự chênh lệch giữa các tùy chọn cho thấy ngưỡng chấp nhận rủi ro là quyết định của người dùng, không phải của mô hình. Đây là điểm rất đáng lưu ý cho các đội data science tại Việt Nam đang triển khai mô hình chấm điểm tín dụng, dự báo churn hay gợi ý sản phẩm — nơi chi phí của một dự đoán sai có thể rất khác nhau tùy bối cảnh.
 Minh họa quy trình hiệu chuẩn và đánh giá độ tin cậy của mô hình
Kết luận
Conformal Prediction mang lại cho đội ngũ phát triển mô hình một lớp thông tin bổ sung quan trọng: không chỉ biết mô hình dự đoán gì, mà còn biết dự đoán đó đáng tin đến đâu. Cách tiếp cận này dễ triển khai, không cần thư viện chuyên dụng, và có thể áp dụng cho hầu hết bài toán dự đoán — từ phân loại nhị phân đến hồi quy phức tạp.
Cần lưu ý rằng đây là hướng dẫn thực hành, không phải chứng minh toán học về bảo đảm bao phủ của thuật toán. Tùy bộ dữ liệu và bối cảnh, các phương pháp định lượng bất định khác có thể phù hợp hơn. Với phương pháp thích ứng, các bảo đảm hình thức không còn được giữ nguyên.
Dù vậy, giá trị thực tiễn là rõ ràng: khi mỗi dự đoán đi kèm một thước đo độ tin cậy, các cuộc trao đổi giữa đội kỹ thuật và lãnh đạo doanh nghiệp trở nên cụ thể và có căn cứ hơn nhiều so với việc chỉ dựa vào các chỉ số tổng hợp.
Bài viết liên quan
Công nghệ
JEP 543 đưa Structured Concurrency vào JDK 28: khép lại 7 vòng xem trước
19 tháng 10, 2026
Công nghệ
Tòa án Đức ra lệnh cấm một chức năng của SAP Signavio sau kiện tụng với Celonis
19 tháng 10, 2026
Phần mềm
KiviDB: Cơ sở dữ liệu trong bộ nhớ viết bằng Rust, nhanh gấp 9 lần Redis
19 tháng 10, 2026