
Đổi một luật Monty Hall, 5 LLM vẫn khuyên đổi cửa
Một thử nghiệm trên các mô hình ngôn ngữ nhỏ cho thấy chúng vẫn trả lời "nên đổi cửa" ngay cả khi luật của người dẫn chương trình bị thay đổi khiến việc đổi cửa luôn thua. Kể cả khi được yêu cầu suy luận từng bước, độ chính xác vẫn chỉ quanh 33%, và có mô hình đọc đúng luật rồi vẫn phớt lờ.
Bạn đã biết đáp án của bài toán Monty Hall quen thuộc: có ba cánh cửa, một chiếc xe và hai con dê, người dẫn chương trình biết xe ở đâu, mở một cửa có dê rồi hỏi bạn có muốn đổi cửa không. Câu trả lời là nên đổi, vì đổi thắng hai lần trong ba. Khi Marilyn vos Savant công bố kết quả này trên tạp chí Parade năm 1990, hàng nghìn độc giả viết thư phản đối, trong đó không ít người là nhà toán học. Bà vẫn đúng.
Ngày nay không ai còn tranh cãi, và các mô hình AI cũng vậy. Hỏi một mô hình, nó trả lời ngay: "đổi".
Vậy nên một tác giả đã thay đổi đúng một luật. Nếu người dẫn chương trình không biết xe ở đâu, và chỉ tình cờ mở trúng cửa có dê thì sao? Hoặc nếu ông ta chỉ đưa ra lời mời đổi cửa khi bạn đã chọn trúng xe thì sao? Vẫn ba cửa, vẫn hai con dê, vẫn câu hỏi đó — nhưng ở phiên bản thứ hai, đổi cửa thua trong mọi trường hợp.
Tác giả đã hỏi năm mô hình AI xem nên làm gì qua sáu phiên bản của bài toán. Cả năm đều trả lời "đổi" với gần như tất cả các phiên bản, kể cả phiên bản mà đổi cửa không thể thắng. Điều đáng lo không phải là chúng sai, mà là chúng nói sai một cách đầy tự tin, và cách chúng lập luận khi được đọc lại còn đáng lo hơn: có mô hình trích dẫn đúng luật của người dẫn chương trình rồi sau đó phớt lờ chính luật đó.
Vì sao người dẫn chương trình mở cửa mới là mấu chốt
Cách giải thích quen thuộc: lựa chọn đầu tiên của bạn đúng với xác suất 1/3, việc người dẫn chương trình mở cửa không làm thay đổi điều đó, nên cửa còn lại phải đúng với xác suất 2/3. Lập luận này gọn và đúng, nhưng theo nhà thống kê Jeffrey Rosenthal, nó đúng một cách "may mắn" — chỉ cần thay đổi nhỏ trong bài toán là nó sụp đổ.
Cái đứng vững là một câu hỏi khác: với hành động vừa xảy ra của người dẫn chương trình, khả năng ông ta làm vậy là bao nhiêu nếu xe ở cửa 1, ở cửa 2, ở cửa 3? Rosenthal gọi đây là Nguyên lý tỷ lệ thuận. Sau khi thấy một sự kiện xảy ra, xác suất mới của mỗi khả năng tỷ lệ thuận với khả năng sự kiện đó xảy ra dưới khả năng ấy. Đây chính là định lý Bayes ở dạng gọn.
 Minh họa bài toán Monty Hall với ba cánh cửa
Áp dụng vào bản kinh điển: bạn chọn cửa 1, người dẫn mở cửa 3. Nếu xe ở cửa 1, ông ta có hai cửa dê để chọn nên mở cửa 3 với xác suất 1/2. Nếu xe ở cửa 2, ông ta buộc phải mở cửa 3, xác suất 1. Nếu xe ở cửa 3, ông ta không thể mở, xác suất 0. Ta được các trọng số 1/2, 1 và 0; chuẩn hóa lại thành 1/3, 2/3 và 0. Đáp án nổi tiếng đến hoàn toàn từ cách hành xử của người dẫn chương trình, không phải từ bản thân các cánh cửa.
Nghĩa là ta có thể thay đổi đáp án bằng cách thay đổi người dẫn chương trình. Bảng dưới tóm tắt các biến thể:
- Monty Hall (kinh điển): người dẫn biết xe ở đâu, mở một cửa dê. Giữ thắng 1/3, đổi thắng 2/3.
- Monty Fall: người dẫn không biết, mở ngẫu nhiên và tình cờ trúng cửa dê. Giữ thắng 1/2, đổi thắng 1/2.
- Monty from Hell: người dẫn chỉ mời đổi cửa khi bạn đã chọn trúng xe. Giữ thắng 1, đổi thắng 0.
- Monty Crawl: người dẫn mở cửa dê có số nhỏ nhất. Nếu thấy cửa 3 được mở, đổi thắng 1; nếu thấy cửa 2 được mở, giữ và đổi hòa nhau 1/2.
- Người dẫn im lặng: không mở cửa nào, chỉ hỏi có muốn đổi sang cửa 2 không. Giữ và đổi đều 1/3.
Nhìn hai dòng cuối của bảng: đổi cửa đi từ luôn thắng đến luôn thua, mà không một cánh cửa nào dịch chuyển. Chỉ có luật của người dẫn chương trình thay đổi. Tác giả cũng kiểm chứng bằng mô phỏng 300.000 ván cho mỗi biến thể, kết quả khớp với tính toán.
Cách đặt câu hỏi cho các mô hình
Tác giả dùng các phiên bản tinh chỉnh theo chỉ dẫn của Qwen2.5 ở bốn kích thước (0.5B, 1.5B, 3B và 7B, trong đó bản 7B chạy lượng tử hóa 4-bit), cộng thêm Phi-3.5-mini, một mô hình 3,8 tỷ tham số thuộc họ khác, để kết quả không chỉ là đặc thù của Qwen.
Với mỗi câu chuyện, tác giả mô tả luật chơi và luật của người dẫn chương trình bằng lời đơn giản, rồi đưa ba lựa chọn: đổi cửa tốt hơn, giữ cửa tốt hơn, hoặc không khác biệt. Thay vì để mô hình viết đáp án, tác giả đọc trực tiếp xác suất mô hình gán cho từng lựa chọn, và hỏi mỗi câu theo cả sáu cách sắp xếp thứ tự để trung hòa thiên kiến chọn chữ cái.
Một con số cần nhớ: trên sáu câu chuyện này, một mô hình luôn trả lời "đổi" sẽ đúng hai và sai bốn — tức 33%.
Kết quả: càng lớn càng chắc chắn, nhưng không hề giỏi hơn
Với bài toán kinh điển, xác suất chọn "đổi cửa" là 59% với bản 0.5B, 81% với bản 1.5B và gần 100% với ba mô hình còn lại. Đúng đáp án — nhưng cũng đúng y như một mô hình đã học thuộc lòng.
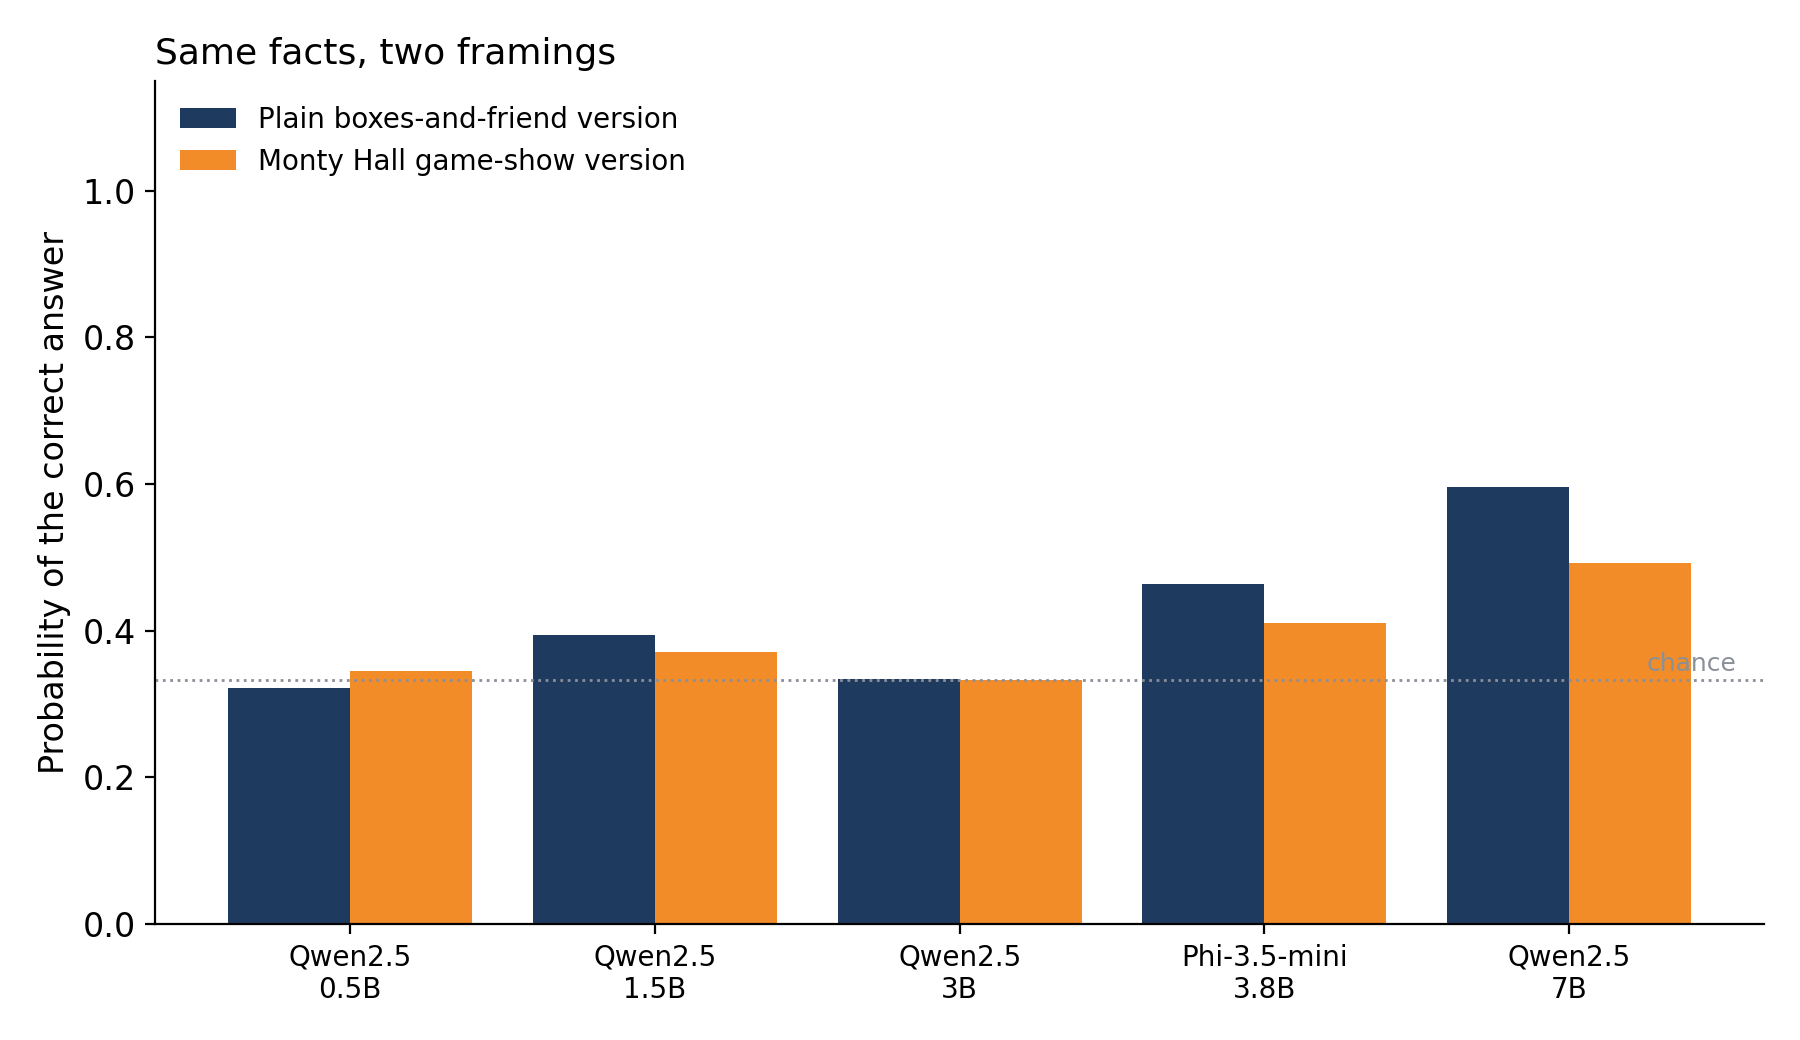 Xác suất các mô hình trả lời "nên đổi cửa" theo từng biến thể
Vấn đề nằm ở bốn biến thể mà "đổi" là câu trả lời sai. Xác suất trung bình các mô hình gán cho phát biểu đúng chỉ là 13% (bản 0.5B), 4,5% (1.5B), 0,0% (3B), 0,4% (Phi) và 3,7% (7B). Đoán ngẫu nhiên còn được 33%. Vậy mô hình lớn hơn không có nghĩa là nhận ra thay đổi tốt hơn, mà chỉ có nghĩa là chắc chắn hơn rằng không có gì thay đổi.
Tác giả đã cố phá kết quả của chính mình bằng nhiều cách: thêm sáu câu hỏi đơn giản cùng định dạng (mô hình 7B và Phi làm đúng hết, bản 3B đúng 91%, bản 1.5B đúng 85%, riêng bản 0.5B chỉ 52% nên khó tin); chạy lại bản 3B ở độ chính xác 32-bit đầy đủ — kết quả y hệt; đổi cách hỏi thành "cửa nào có khả năng che xe cao hơn?" — bản 1.5B tụt từ 81% xuống 38%, cho thấy các mô hình nhỏ phản ứng với từ ngữ nhiều hơn là với logic.
Khi manh mối nằm ở hành vi của người dẫn
Có một thử nghiệm đối chứng khá rõ: người dẫn chương trình trung thực nói thẳng với bạn rằng xe ở cửa 1, chính cửa bạn đã chọn, rồi mời đổi. Đáp án hiển nhiên là giữ. Bản 3B vẫn nói "đổi" với xác suất gần 100%, Phi nói 67% số lần, còn bản 7B chỉ chọn "đổi" 3,5%, chia phần còn lại giữa "giữ" (48%) và "không khác biệt" (49%).
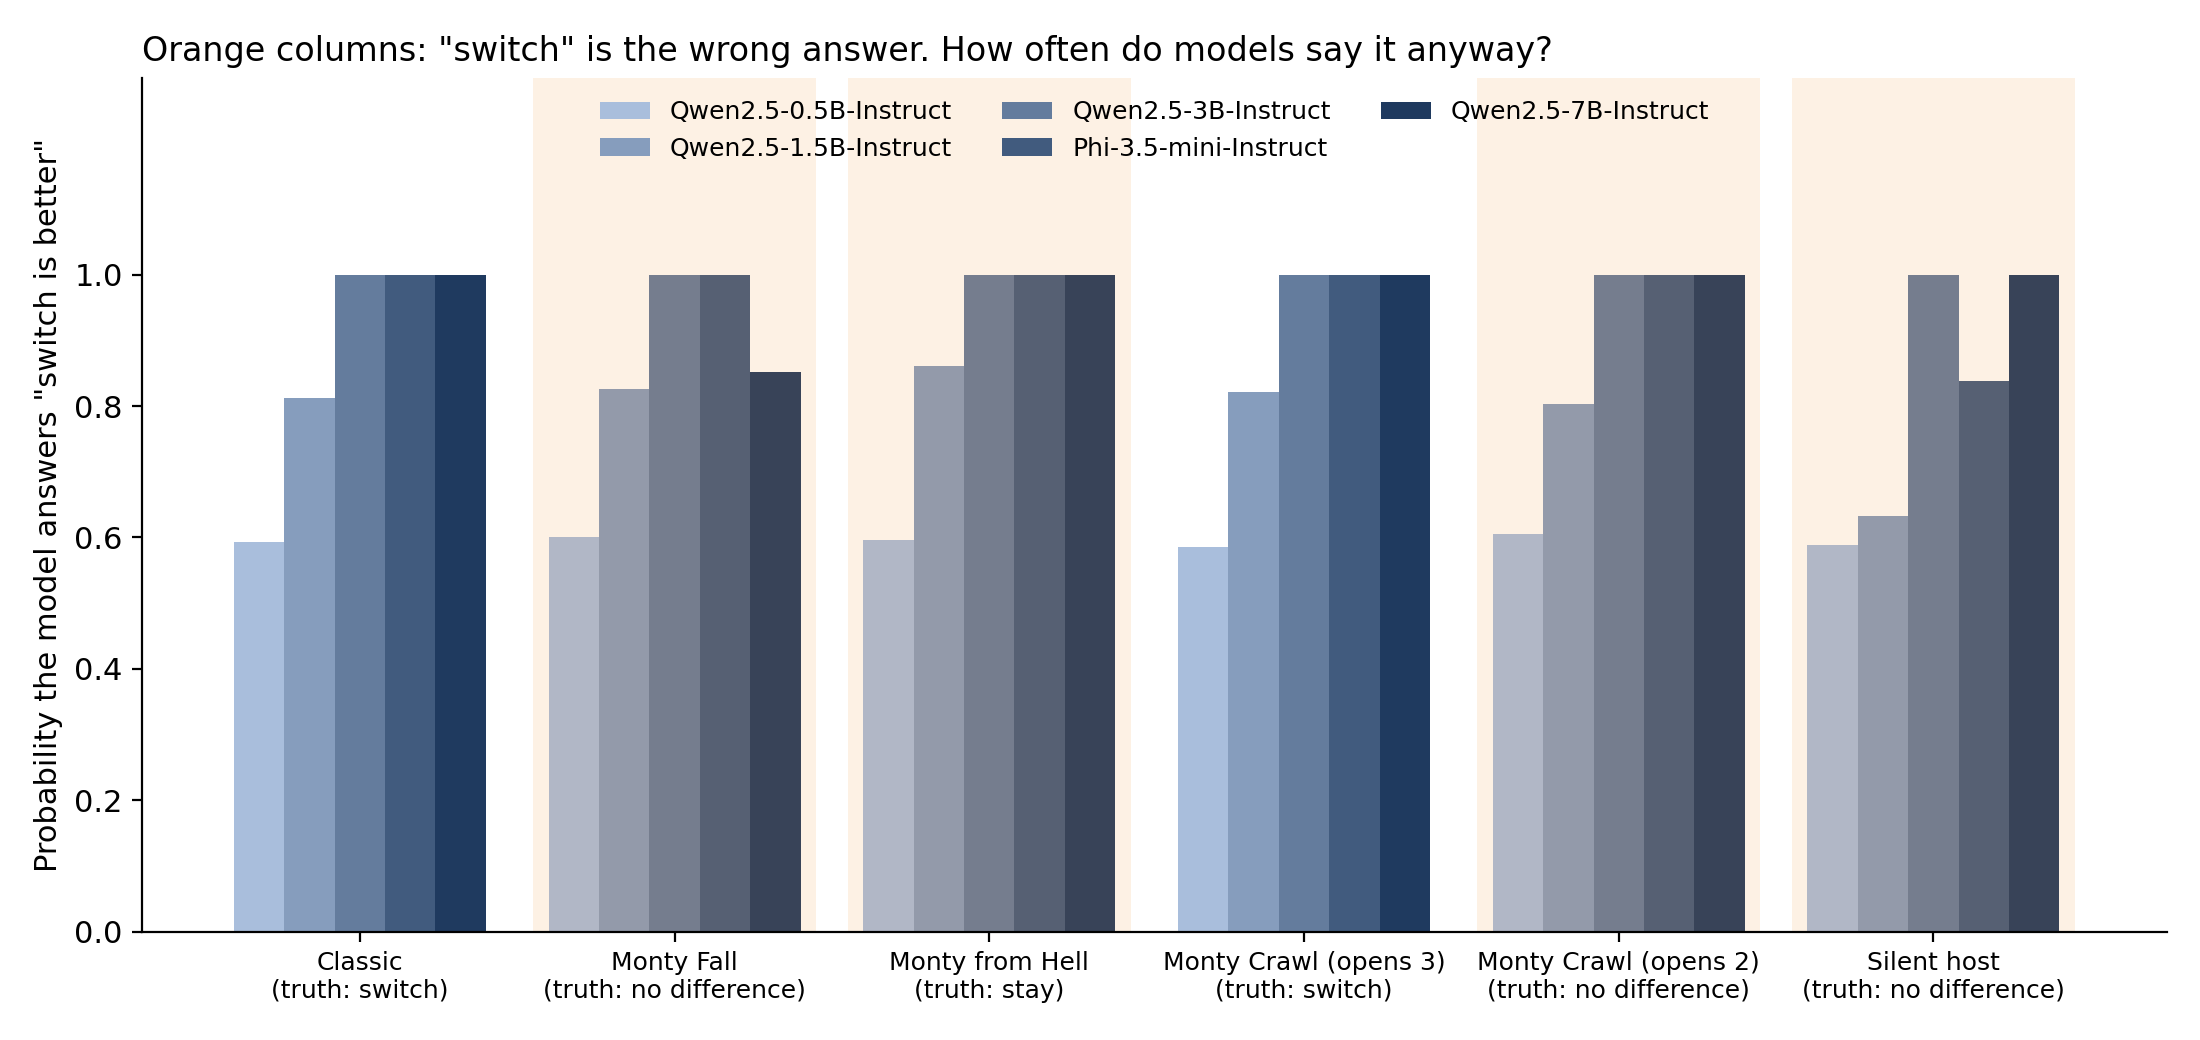
Tác giả cũng nghi ngờ chính bối cảnh game show là thứ kích hoạt câu trả lời đã học thuộc, nên viết lại thành phiên bản không có cửa, không có dê: một phần thưởng trong ba chiếc hộp, và một người bạn hoặc nói thật hoặc không biết gì. Kết quả gần như không đổi: bản 3B đúng 33% ở cả hai phiên bản, Phi tăng từ 41% lên 46%, bản 7B từ 49% lên 60% — có cải thiện nhưng không nhiều.
Điều này cho thấy vấn đề không nằm ở "cửa và dê" mà ở cấu trúc tình huống: ba lựa chọn, bạn chọn một, có ai đó mời bạn đổi. Bản viết lại vẫn mang cấu trúc đó, nên tác giả không thể xác định ranh giới của hiện tượng, chỉ có thể khẳng định rằng bỏ lớp "áo" game show là chưa đủ.
Cho mô hình suy luận từng bước cũng không cứu được
Phản biện hợp lý: không ai giải bài toán xác suất trong một tích tắc. Vậy tác giả để các mô hình viết ra lập luận trước (năm chuỗi lấy mẫu mỗi câu chuyện, tối đa 600 token mỗi chuỗi, 55 chuỗi mỗi mô hình) rồi đọc đáp án ở cuối.
Kết quả không khả quan hơn. Trên 30 chuỗi thuộc sáu biến thể chính, các mô hình kết thúc bằng "đổi" 80% số lần với bản 0.5B, 97% với 1.5B, 100% với 3B và Phi, 97% với 7B. Độ chính xác lần lượt là 33%, 30%, 33%, 33% và 37% — xấp xỉ mức của một mô hình luôn nói "đổi".
Phần thú vị nhất của thử nghiệm nằm trong chính các chuỗi suy luận. Ở câu chuyện Monty from Hell, một chuỗi của bản 7B nêu đúng luật (nếu bạn chọn dê, "người dẫn sẽ không mời đổi cửa"), rồi vài dòng sau lại kết luận nên đổi "nếu ban đầu bạn chọn dê, điều có khả năng cao hơn". Mô hình có cả xác suất tiên nghiệm lẫn bằng chứng, nhưng chọn đi theo tiên nghiệm, và không chỗ nào tự hỏi khả năng người dẫn đưa ra lời mời này là bao nhiêu trong từng trường hợp.
Ở câu chuyện Monty Fall, một chuỗi của bản 3B lại mở đầu bằng "Vì người dẫn biết xe ở đâu…" — tức là bài toán kinh điển chứ không phải bài toán được giao. Nó đã âm thầm viết lại đề thành phiên bản mình còn nhớ. Còn ở phiên bản hộp, một chuỗi của bản 7B nói hộp 2 "vẫn có 0% khả năng nếu phần thưởng đúng là ở hộp 1 như người bạn đã chỉ ra", rồi vẫn trả lời "đổi" sang hộp 2.
Một cái công tắc, không phải một núm vặn
Một thử nghiệm cuối, vì phần toán ở đây khá đẹp. Với N cánh cửa và người dẫn chương trình biết xe ở đâu, mở k cửa dê, xác suất thắng khi đổi sang một cửa còn lại là (N−1)/(N(N−1−k)), còn giữ cửa thắng với xác suất 1/N. Khi k = 0, hai lựa chọn hòa nhau; đến k = 8, đổi cửa tốt hơn chín lần.
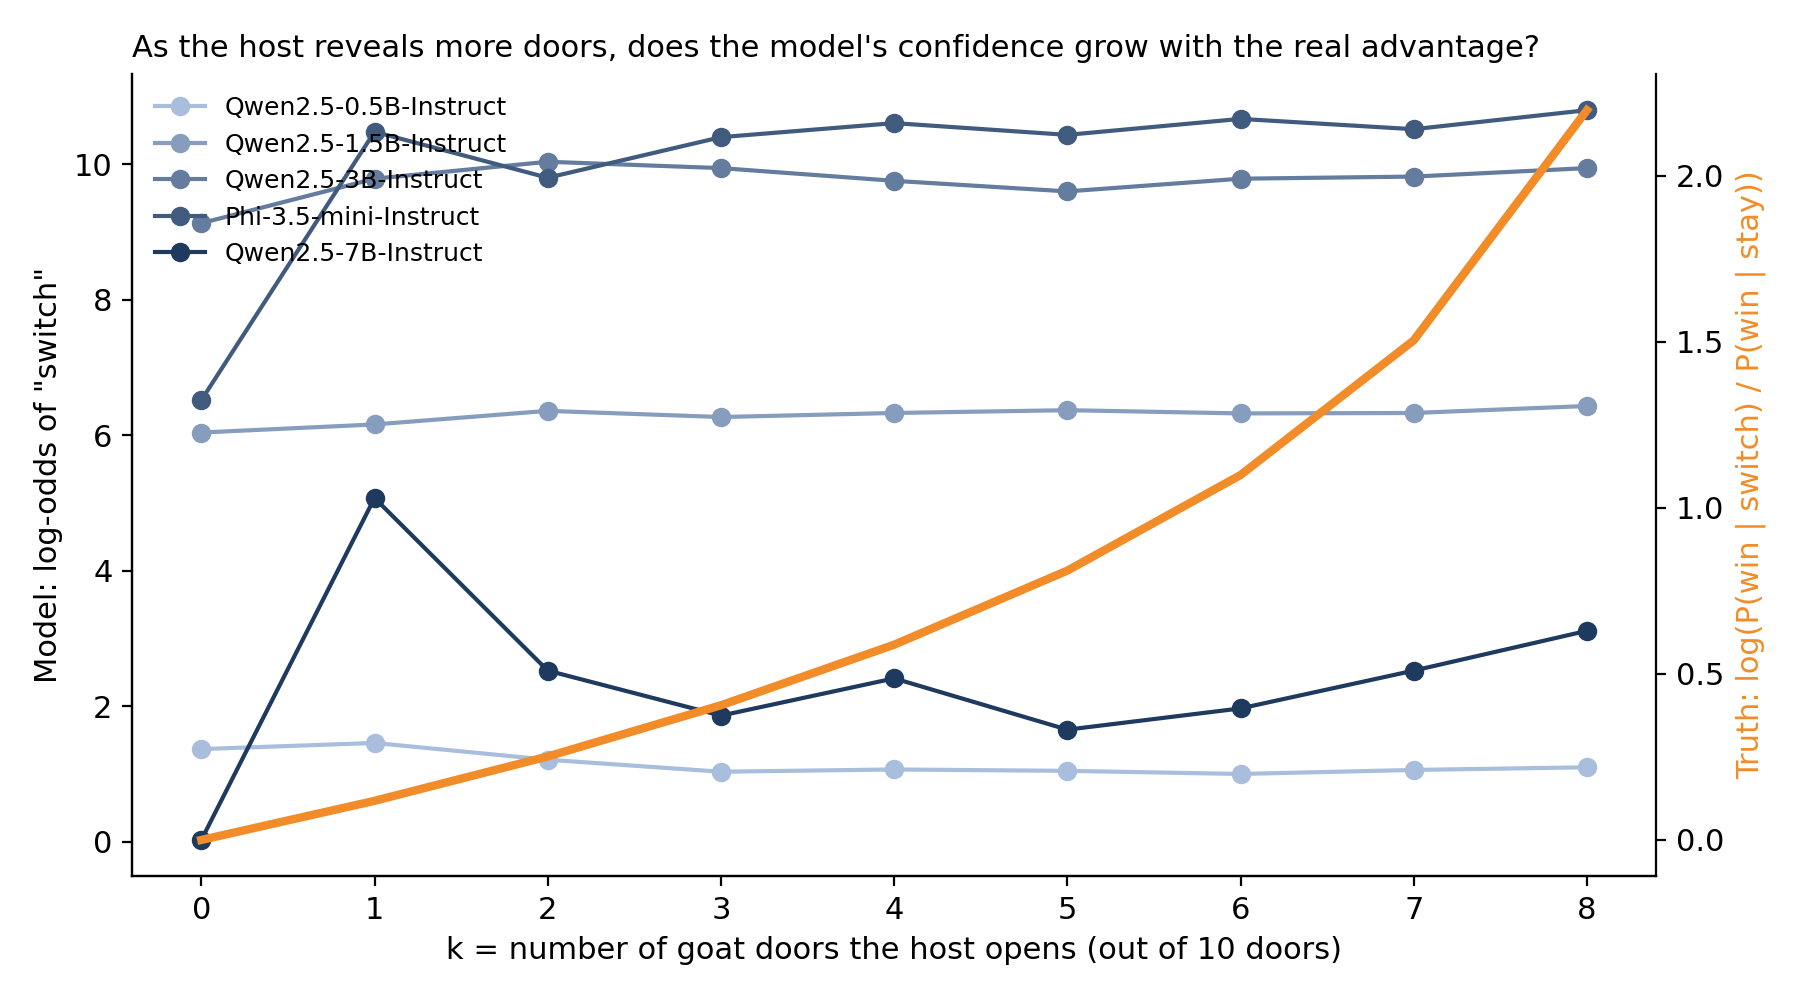 Độ tin cậy của mô hình vào "đổi cửa" khi người dẫn mở thêm cửa, so với lợi thế thật của việc đổi
Bản 7B xử lý đúng trường hợp k = 0: 51% chọn "đổi", gần như ú ớ. Nhưng đến k = 1, nó nhảy lên 99% và giữ trong khoảng 84–96% với mọi k lớn hơn, không hề tăng dù đổi cửa ngày càng rõ ràng là đúng. Bản 3B và Phi nói "đổi" với xác suất 99,9% trở lên ngay cả khi người dẫn không mở cửa nào. Một mô hình bám theo toán học sẽ tự tin hơn sau mỗi cánh cửa được mở; các mô hình này hành xử như công tắc bật/tắt chứ không như núm vặn.
Giới hạn của nghiên cứu
Đây là một nghiên cứu nhỏ: các mô hình từ 0,5B đến 7B, một mô hình bị lượng tử hóa, bốn mô hình cùng một họ, chỉ xét câu trả lời nhanh và các chuỗi suy luận ngắn. Sáu câu chuyện, vài thử nghiệm đối chứng, năm chuỗi mỗi câu chuyện. Việc đếm các chuỗi viết lại đề dựa trên đọc văn bản và tìm mẫu đơn giản, nên chỉ nên xem là ví dụ chứ không phải tần suất. Không có mô hình tiên tiến nào được kiểm tra — dù một nghiên cứu khác trên 25 bài toán kinh điển, 149 phiên bản chỉnh sửa và 11 mô hình hàng đầu (kể cả mô hình đóng) cũng báo cáo kiểu thất bại tương tự: đưa ra đáp án đã học thuộc cho một bài toán không còn khớp.
Kết luận tác giả đưa ra khá hẹp: với các mô hình này, giải đúng một bài toán nổi tiếng là bằng chứng yếu về năng lực suy luận, vì cùng một đáp án xuất hiện dù bài toán có bị thay đổi hay không. Phép thử rẻ nhất là đổi một luật để đáp án đúng đảo ngược, rồi xem đáp án có đảo theo không.
Góc nhìn
Với lập trình viên và kỹ sư AI ở Việt Nam, kết quả này là lời nhắc thực tế về cách đánh giá mô hình. Nhiều nhóm đang tích hợp LLM vào sản phẩm và dùng các bộ câu hỏi chuẩn để chọn mô hình; nếu bộ câu hỏi toàn những bài đã phổ biến trên mạng, điểm cao có thể chỉ phản ánh khả năng ghi nhớ chứ không phải khả năng suy luận. Cách kiểm tra rẻ và hiệu quả là tự tạo biến thể: giữ nguyên cấu trúc nhưng đổi một điều kiện khiến đáp án đúng đảo ngược, và quan sát mô hình có bám theo không.
Điểm thứ hai là đừng đọc câu trả lời một cách rời rạc. Các chuỗi suy luận ở trên cho thấy mô hình có thể nêu đúng dữ kiện rồi tự mâu thuẫn ở bước sau, hoặc âm thầm viết lại đề bài thành phiên bản quen thuộc. Khi xây hệ thống cần độ tin cậy — ví dụ tính toán tài chính, cấu hình hạ tầng, xử lý dữ liệu — nên xem đầu ra của mô hình là gợi ý cần kiểm chứng bằng quy tắc hoặc mã thực thi, thay vì tin vào giọng điệu tự tin của nó.
Nguồn: towardsdatascience.com · Quy trình biên tập
Bài viết liên quan
Công nghệ
Bài toán Monty Hall dưới góc nhìn Bayes: Khi xác suất phụ thuộc vào người dẫn chương trình
18 tháng 10, 2026
Công nghệ
Sáu mô hình AI của bạn thực ra chỉ đáng hai: Bài toán của những sai lầm tương quan
23 tháng 10, 2026
Phần mềm
Mất bao nhiêu lần đoán để bẻ khóa con số "ngẫu nhiên" của AI?
15 tháng 10, 2026