"Hiệu ứng Matthew" trong học tăng cường cho LLM: Vì sao AI giỏi câu dễ mà bó tay câu khó
Nghiên cứu mới chỉ ra rằng học tăng cường (RL) cho các mô hình ngôn ngữ lớn thường chỉ cải thiện các bài toán dễ mà bỏ qua các bài toán khó — hiện tượng được gọi là "Hiệu ứng Matthew". Nhóm tác giả đề xuất phương pháp Never Give Up nhằm phân bổ lại tài nguyên tính toán, giúp mô hình giải được nhiều bài toán khó hơn mà không làm giảm hiệu năng ở các bài dễ.
"Hiệu ứng Matthew" trong học tăng cường cho LLM: Vì sao AI giỏi câu dễ mà bó tay câu khó
Các mô hình ngôn ngữ lớn (LLM) sau khi được huấn luyện bằng học tăng cường (RL) thường cho thấy điểm số tăng vọt trên các bài kiểm tra toán. Nhưng đằng sau đường cong đẹp đẽ đó là một sự thật ít ai để ý: phần lớn tiến bộ đến từ những bài toán dễ, còn các bài toán khó gần như giậm chân tại chỗ.
Một nghiên cứu mới của Michael Noukhovitch cùng các cộng sự đã đặt tên cho hiện tượng này là "Hiệu ứng Matthew" trong RL cho LLM, đồng thời đề xuất phương pháp Never Give Up để khắc phục.
Điểm số trung bình đang che giấu điều gì?
Hãy tưởng tượng một bài kiểm tra toán AIME 2025 gồm 30 câu. Khi huấn luyện mô hình Olmo 3.1 RL-Zero bằng RL, điểm trung bình tăng đều đặn — trông rất khả quan.
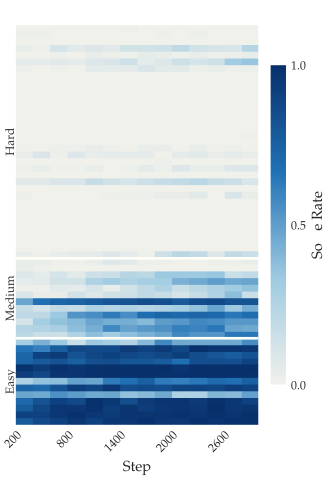
Nhưng khi chia 30 câu này thành ba nhóm theo độ khó dựa trên năng lực ban đầu của mô hình:
- Dễ: mô hình đã giải được khoảng 22,7% ngay từ đầu
- Trung bình: khoảng 3,8%
- Khó: 0% (mô hình không giải được câu nào dù thử 32 lần — pass@32 = 0)
Kết quả thật bất ngờ: các câu dễ cải thiện rõ rệt, câu trung bình tiến bộ vừa phải, còn các câu khó gần như không nhúc nhích — vẫn giữ nguyên pass@32 = 0 sau suốt quá trình huấn luyện.
Tỷ lệ giải được của từng câu hỏi AIME qua quá trình huấn luyện
Nói cách khác, đường cong điểm trung bình đang che giấu một thực tế: mô hình chỉ đang "học lại" những gì nó đã gần giải được, chứ không thực sự chinh phục được các bài toán khó.
RL cải thiện hiệu năng trên một tác vụ tỷ lệ thuận với năng lực ban đầu của mô hình — làm bài dễ càng dễ, còn bài khó thường vẫn khó.
Hiện tượng này không chỉ xuất hiện trong toán học. Khi kiểm tra với các bài toán lập trình (Deepcoder, SWE-bench) và tác vụ agent, nhóm nghiên cứu cũng quan sát thấy mức cải thiện tỷ lệ thuận với độ dễ của bài toán.
Nguyên nhân: không chỉ là "mất tín hiệu"
Trực giác đầu tiên là vấn đề nằm ở thuật toán GRPO — nếu trong k lần sinh câu trả lời không có câu nào đúng, mô hình sẽ không nhận được gradient nào để học, hiện tượng gọi là "mất tín hiệu" (signal loss).
Giải pháp tưởng chừng đơn giản: tăng k lên, sinh nhiều câu trả lời hơn để có cơ hội tìm ra đáp án đúng hiếm hoi cho bài khó.
Nhưng thực nghiệm lại cho kết quả ngược lại. Khi huấn luyện Qwen 2.5 0.5B trên GSM8k platinum với các giá trị k khác nhau (4, 8, 16, 32), nhóm nghiên cứu phát hiện:
- k = 4 lại giải được nhiều bài khó hơn k = 32
- Với k = 32, mô hình cũng có nhiều cơ hội tìm ra đáp án sai hiếm hoi cho bài dễ, khiến lô huấn luyện bị lãng phí vào các bài dễ
Điểm mấu chốt: vấn đề không chỉ là thiếu mẫu cho bài khó, mà là tiêu tốn quá nhiều tài nguyên cho bài dễ. Nhóm tác giả gọi đây là vấn đề "hiệu quả tín hiệu" (signal efficiency), khác với "mất tín hiệu".
Never Give Up: nhỏ với bài dễ, kiên trì với bài khó
Ý tưởng cốt lõi rất đơn giản: dùng k nhỏ cho bài dễ và k lớn cho bài khó — nhưng làm sao biết trước bài nào khó?
Phương pháp Never Give Up (NGU) giải quyết điều này một cách thích ứng:
- Bắt đầu sinh k câu trả lời với k nhỏ (ví dụ 4)
- Nếu bài toán được giải trong k câu đó → huấn luyện luôn
- Nếu tất cả k câu đều đúng → lọc bỏ nhanh chóng (bài quá dễ)
- Nếu tất cả k câu đều sai → với xác suất p, không bỏ cuộc, mà đưa bài toán trở lại và sinh thêm k câu nữa
- Khi cuối cùng giải được, huấn luyện trên toàn bộ số câu đã sinh qua các vòng
Cách làm này tạo ra phân phối hình học cho số mẫu cần lấy: trung bình là k/(1-p) mẫu. Nó tự động thích ứng — bài dễ được lọc nhanh, bài khó được kiên trì theo đuổi.
Kết quả trên GSM8k: k = 4 với NGU p = 0.9 vượt qua mọi giá trị k của GRPO tiêu chuẩn, đặc biệt rõ rệt ở nhóm bài khó nhất. NGU đạt được "điểm ngọt" của cả k lớn (đầu quá trình huấn luyện) lẫn k nhỏ (về sau).
Mở rộng quy mô: từ toán đến lập trình
Nhóm nghiên cứu đã thử nghiệm NGU trên quy mô lớn hơn với DeepScaler và Qwen 3 4B base, huấn luyện khoảng 120 giờ H100. Trên nền tảng GRPO k = 16 mạnh, NGU tiếp tục cải thiện hiệu năng, đặc biệt ở các nhóm bài khó nhất của AIME và BRUMO 2025.
Với lập trình, câu chuyện phức tạp hơn vì một bài lập trình gồm nhiều test từ dễ đến khó — không chỉ đúng/sai đơn thuần. Trên benchmark Manufactoria, GRPO tiêu chuẩn cải thiện rồi chững lại: nó liên tục xoay quanh các test trung bình, khi thì giải thêm được chút, khi thì mất đi.
NGU thay đổi cục diện: nếu k câu đầu tiên đều chỉ vượt 7/12 test, NGU không chấp nhận k câu tiếp theo trừ khi chúng vượt qua mốc đó — thúc đẩy mô hình tiến bộ dần dần cho đến khi giải trọn vẹn cả bài.
Hiệu ứng Matthew không phải do "tính dẻo" của mạng nơ-ron
Một giả thuyết được đặt ra: liệu hiệu ứng Matthew có phải là một dạng "thiên kiến nguyên thủy" (primacy bias) — mô hình bị "đóng băng" vào trạng thái ban đầu, tương tự hiện tượng từng thấy trong deep RL?
Thực nghiệm cho câu trả lời: không. Nhóm nghiên cứu lấy một checkpoint đã đứng yên hơn 3000 bước, rồi thử hai cách: đổi sang phần thưởng chỉ khi vượt toàn bộ test, hoặc giữ phần thưởng từng test kèm NGU. Cả hai cách đều phục hồi hiệu năng mạnh mẽ, chứng tỏ vấn đề không nằm ở tính dẻo của mạng nơ-ron mà ở cách phân bổ tín hiệu huấn luyện.
Hạn chế và kết luận
NGU không phải thuốc chữa vạn năng. Nếu tập dữ liệu chủ yếu toàn bài cực khó, phương pháp này sẽ kém hiệu quả vì không có bài dễ để lọc. Quy trình "sinh, chờ, sinh thêm" cũng khiến mẫu ban đầu bị "cũ" (off-policy) hơn so với việc sinh thẳng k/(1-p) câu ngay từ đầu, dẫn đến tín hiệu học kém hơn và tốc độ học chậm hơn.
Tuy nhiên, nếu đã biết giá trị k hợp lý cho phân phối dữ liệu của mình, NGU vẫn có thể mang lại hiệu quả đáng kể.
Bài học lớn nhất từ nghiên cứu này dành cho những ai làm việc với LLM: đừng chỉ nhìn vào một con số trung bình. Điểm eval tổng hợp có thể che giấu những khoảng trống nghiêm trọng về năng lực. Việc phân tích tín hiệu eval chi tiết và dày đặc hơn sẽ giúp hiểu rõ mô hình thực sự học được gì — và bỏ sót gì.
Những cải tiến thực sự không đến từ việc làm bài dễ dễ hơn, mà từ việc kiên trì không bỏ cuộc trước những bài toán khó.