
Kết quả cho “LLM” trong AI & ML
519 bài viếtXoá tìm kiếm
Hiệu ứng LLMentalist: Khi chatbot AI lặp lại chiêu trò của những kẻ ngoại cảm
20/09/2026
Mercury 2.5 đạt tốc độ 770 token mỗi giây, nhanh thứ hai trong bảng xếp hạng LLM
24/09/2026
Jev và LLM: Khi AI chuyển từ tạo sinh sang ra quyết định
25/09/2026
Dấu thủy vân trên LLM có thể làm thay đổi hành vi của AI Agent
26/09/2026
"Token-space font": Công cụ tạo font chữ nơi mỗi token LLM có cùng độ rộng
26/09/2026
Kỷ nguyên LLM: Khi việc xây dựng công cụ nhỏ trở nên đáng giá hơn bao giờ hết
06/10/2026
Viết như năm 1866: LLM học lại cách viết điện báo để tiết kiệm token
07/10/2026
Hiểu tường tận về cách hoạt động của LLM: Không hề có phép màu nào ở đây
12/10/2026
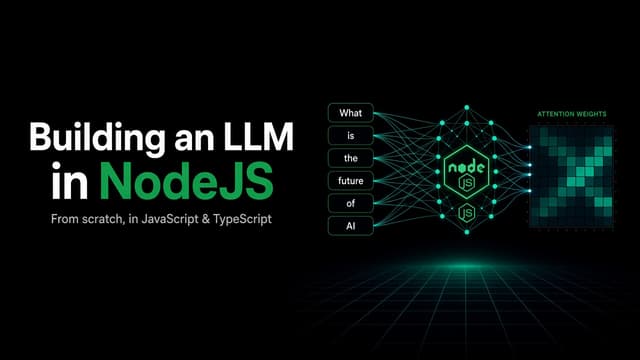
Xây dựng mô hình LLM từ con số 0 bằng TypeScript: Hành trình gỡ bỏ mọi 'hộp đen' của transformer
14/10/2026
Vì sao mọi LLM đều vẽ chim bồ nông giống hệt nhau?
14/10/2026
Làm sao để LLM 'Hệ thống 1' đạt được năng lực của 'Hệ thống 2'?
16/10/2026
Tự vận hành LLM proxy: Cách để thực sự hiểu điều gì đang diễn ra với mô hình AI của bạn
19/10/2026
Harness Engineering 101: Khi LLM là bộ não và harness là cơ thể
19/10/2026
Chi phí ẩn của định tuyến LLM: Vì sao chuyển model giữa chừng lại tốn hơn bạn tưởng
20/10/2026
Aiven xây dựng cổng LLM nội bộ, cắt giảm 80% chi phí token AI
26/10/2026
Tối ưu hóa suy luận LLM quy mô lớn: Lợi thế ẩn từ KV Cache
27/10/2026
Trợ lý sinh tồn offline chạy từ USB, dùng LLM cục bộ và Kiwix
05/11/2026
Dự án smolmaxxing chạy LLM 16B trên TV box 2GB và iPad Air 2013
12/11/2026
PostHog: dùng mô hình ra quyết định thay LLM cho việc đơn giản
18/11/2026
Chạy mô hình AI cục bộ (Local LLM) giờ đây đã thực sự tuyệt vời
16/06/2026
/
Xem nhiều nhất
- 1
Roblox ra mắt tài khoản "Kids" và "Select" để kiểm soát nội dung phù hợp lứa tuổi
- 2
Excalidraw: bảng vẽ trực tuyến miễn phí, không cần đăng nhập
- 3
X (Twitter) chặn hàng loạt tài khoản người dùng thật vì lỗi thuật toán "hành vi không xác thực"
- 4
Kính Thông Minh Tốt Nhất Năm 2026: Đánh Giá Meta, Viture, Xreal và Khác
- 5
Nên mua iPad nào năm 2026: So sánh Air, Pro, Mini
- 6
GitHub tạm dừng đăng ký Copilot Pro vì thiếu hụt tài nguyên
/
Từ khóa phổ biến
/