
Kết quả cho “LLM” trong Phần cứng
47 bài viếtXoá tìm kiếm
Thuế KV Cache: Vì sao máy chủ suy luận LLM cạn kiệt VRAM trước khi hết năng lực tính toán
16/09/2026

Giải mã nhân EP hiệu suất cao: Cốt lõi tối ưu cho LLM quy mô lớn
10/06/2026
Tác giả Redis ra mắt ds4, chạy LLM cục bộ bằng C
03/10/2026
Tôi đã xây dựng một Backend C++ để GPU ngừng "ăn gió": Tối ưu hóa hiệu suất LLM
03/06/2026
Tóm lược công nghệ: Mạng di động mới lọc nội dung, công cụ gỡ lỗi LLM và làn sóng AI mã nguồn mở
01/05/2026
WhichLLM: Công cụ tìm kiếm mô hình AI tối ưu nhất cho cấu hình máy tính của bạn
15/05/2026
MegaTrain: Huấn luyện mô hình ngôn ngữ lớn 100 tỷ tham số trên một GPU duy nhất
08/04/2026
Cụm 7 vi điều khiển ESP32-S3 chạy mô hình ngôn ngữ 1,58-bit (BitNet)
29/09/2026
Xe tự hành FLIP của Astrolab sẽ là thiết bị đầu tiên chạy mô hình ngôn ngữ lớn trên Mặt Trăng
21/10/2026
Lucebox: Tối ưu hóa Qwen3.5 đạt 207 tok/s trên RTX 3090 nhờ viết lại Kernel
21/04/2026
Prefill là bài toán tính toán, Decode là bài toán bộ nhớ: Tại sao GPU không nên làm cả hai?
15/04/2026
Nhân viên của bạn đang chạy AI cục bộ: Tại sao suy luận trên thiết bị trở thành "điểm mù" mới của CISO?
12/04/2026
Apple Silicon đắt đỏ hơn OpenRouter: Khi chạy AI trên đám mây tiết kiệm hơn phần cứng
19/05/2026
Verity: Công cụ kiểm chứng sự thật giúp AI cục bộ "nói thật" hơn
14/05/2026
EIE: Máy chủ suy luận cục bộ hỗ trợ TurboQuant, nhóm mô hình và đa GPU
08/04/2026
VRAM là "RAM" mới: Hướng dẫn thực tế chạy Large Language Models trên GPU phổ thông
07/04/2026
Thử nghiệm Speculative Decoding trên cụm GPU tại nhà: Tại sao nó không hiệu quả?
06/04/2026
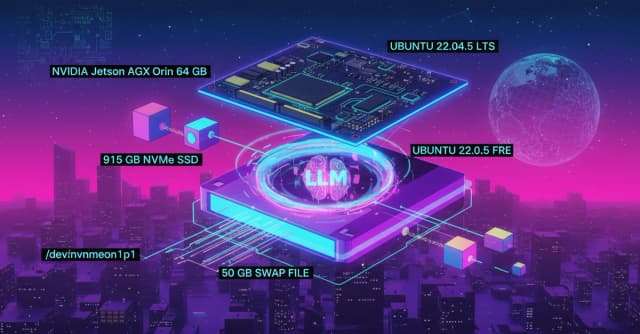
Tạo Swap File 50 GB trên Jetson AGX Orin: Tối ưu hóa cho mô hình AI lớn
06/04/2026
"Nếu điều này là sự thật, các ông lớn hyperscaler sẽ gặp nguy": Tương lai AI thuộc về mô hình ngôn ngữ nhỏ?
20/08/2026
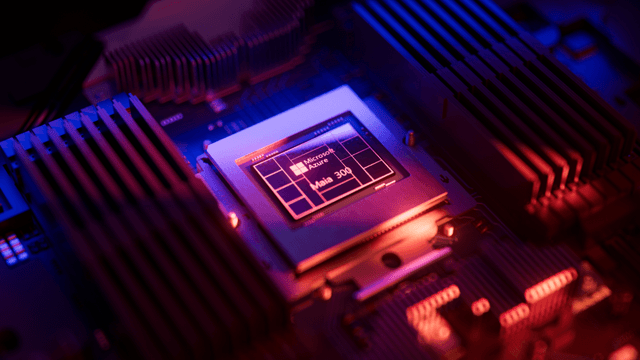
Azure Maia 300: Kiến trúc chip AI tối ưu suy luận quy mô đám mây
12/10/2026
/
Xem nhiều nhất
- 1
Roblox ra mắt tài khoản "Kids" và "Select" để kiểm soát nội dung phù hợp lứa tuổi
- 2
Excalidraw: bảng vẽ trực tuyến miễn phí, không cần đăng nhập
- 3
X (Twitter) chặn hàng loạt tài khoản người dùng thật vì lỗi thuật toán "hành vi không xác thực"
- 4
Kính Thông Minh Tốt Nhất Năm 2026: Đánh Giá Meta, Viture, Xreal và Khác
- 5
Nên mua iPad nào năm 2026: So sánh Air, Pro, Mini
- 6
GitHub tạm dừng đăng ký Copilot Pro vì thiếu hụt tài nguyên
/
Từ khóa phổ biến
/