
Kết quả cho “LLM” trong Phần cứng
47 bài viếtXoá tìm kiếm
Llmspeed: Công cụ giúp ước lượng tốc độ chạy LLM cục bộ trước khi mua phần cứng
17/10/2026

Chạy LLM cục bộ trên Apple Silicon: Có thực sự tiết kiệm hơn so với OpenRouter?
17/05/2026
13 LLM gọi công cụ: mô hình 3,4GB đạt 97,5%, đánh bại bản 25GB
08/04/2026
Chạy LLM cục bộ trên Mac: máy nào phù hợp, công cụ nào miễn phí và đâu là điều không cần thiết
25/09/2026
Cơn sốt vàng LLM trên đám mây đã chấm dứt: Bài học từ Apple và tương lai của AI nội bộ
14/06/2026
Huấn luyện LLM bằng Swift: Hành trình tối ưu hóa nhân ma trận từ Gflop/s lên Tflop/s
11/05/2026
Cẩm nang mua sắm Mini PC chạy Local LLM năm 2026: Giá tăng gấp đôi và đâu là lựa chọn tốt nhất?
02/05/2026
Chạy Local LLMs ngoại tuyến trên chuyến bay 10 tiếng: Bài học từ MacBook M5 Max
27/04/2026
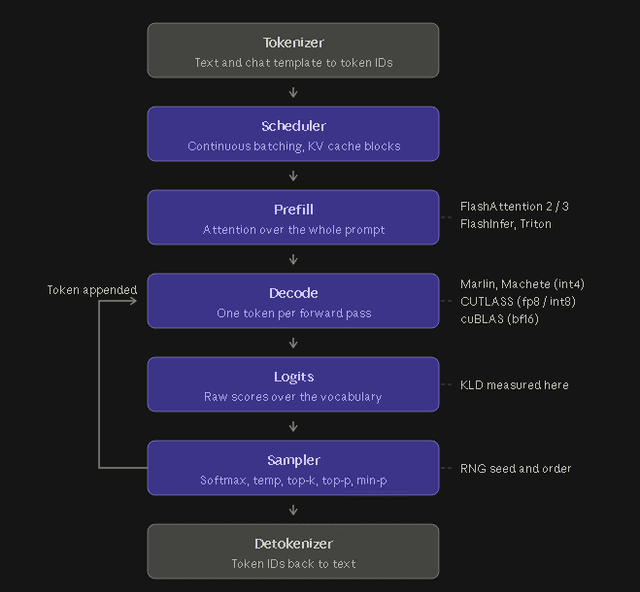
Vì sao LLM chạy local của bạn có vẻ 'ngu' hơn thực tế?
23/08/2026
OpenAI dùng chính LLM của mình để thiết kế chip Jalapeño
19/09/2026
Dự án smolmaxxing chạy LLM 16B trên TV box 2GB và iPad Air 2013
12/11/2026
Tiny-vLLM: Hướng dẫn xây dựng engine suy luận LLM hiệu năng cao bằng C++ và CUDA
30/05/2026
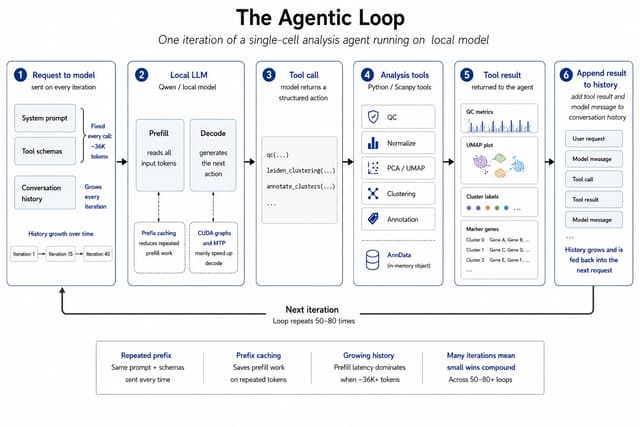
Xây dựng hạ tầng tối ưu cho tác nhân LLM cục bộ: Bài học từ thực tế
28/05/2026
Unsloth và Nvidia hợp tác giúp tăng tốc độ huấn luyện LLM lên 25% trên GPU phổ thông
07/05/2026
Cloudflare xây dựng hạ tầng hiệu suất cao để vận hành các mô hình ngôn ngữ lớn (LLM)
03/05/2026
PrismML ra mắt mô hình LLM 1-bit Bonsai 8B tiết kiệm điện
04/04/2026
Thiết bị AI biên nhỏ nhất thế giới: Chạy LLM cục bộ ngay trong lòng bàn tay
08/09/2026
Thư viện Quốc gia Na Uy xây dựng LLM chủ quyền với sự hỗ trợ của 2 PB bộ nhớ flash Huawei
26/05/2026
TurboQuant của Google: Thuật toán nén mới giúp chạy LLM trên phần cứng khiêm tốn hơn mà vẫn giữ nguyên độ chính xác
15/04/2026
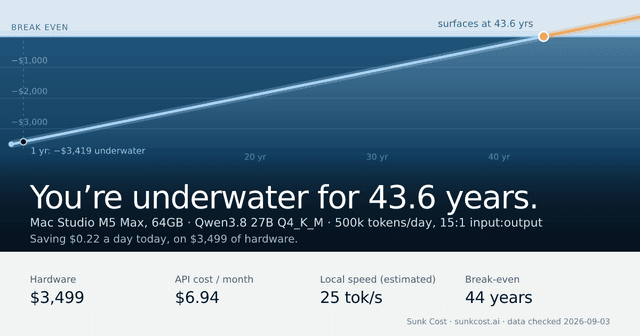
Sunk Cost: Công cụ tính toán thời gian hoàn vốn khi tự mua máy chạy LLM
15/09/2026
/
Xem nhiều nhất
- 1
Roblox ra mắt tài khoản "Kids" và "Select" để kiểm soát nội dung phù hợp lứa tuổi
- 2
Excalidraw: bảng vẽ trực tuyến miễn phí, không cần đăng nhập
- 3
X (Twitter) chặn hàng loạt tài khoản người dùng thật vì lỗi thuật toán "hành vi không xác thực"
- 4
Kính Thông Minh Tốt Nhất Năm 2026: Đánh Giá Meta, Viture, Xreal và Khác
- 5
Nên mua iPad nào năm 2026: So sánh Air, Pro, Mini
- 6
GitHub tạm dừng đăng ký Copilot Pro vì thiếu hụt tài nguyên
/
Từ khóa phổ biến
/